PaddleOCR-VL 使用教程:百度 0.9B 多语言 OCR 模型完全指南 | 支持 109 种语言文档解析
PaddleOCR-VL 完整使用教程:百度最新 0.9B 参数文档解析 AI 模型,支持 109 种语言 OCR 识别,文本表格公式图表一键解析,提供 Docker 部署和 Python API 集成方案,SOTA 性能超越 GPT-4V。
本文发布于 334 天前,内容可能已过时,请注意甄别。
什么是 PaddleOCR-VL?
PaddleOCR-VL 是百度推出的革命性文档解析 AI 模型,采用先进的视觉语言模型(VLM)技术,仅用 0.9B 参数就实现了超越大型模型的性能表现。这款 OCR 工具支持 109 种语言的文档识别,能够一键解析文本、表格、数学公式和图表等复杂文档元素。
与传统 OCR 工具相比,PaddleOCR-VL 不仅识别准确率更高,还具备强大的文档理解能力,是目前市面上最先进的开源文档解析解决方案之一。
💡 想要处理多语言文档、复杂表格或数学公式?PaddleOCR-VL 可能是你的最佳选择。
PaddleOCR-VL 核心特性
🎯 紧凑而强大的模型架构
PaddleOCR-VL 的核心是一个仅有 0.9B 参数的视觉语言模型,采用了创新的技术架构:
- NaViT 风格动态分辨率视觉编码器:能够处理不同尺寸的输入图像
- ERNIE-4.5-0.3B 语言模型:提供强大的语言理解和生成能力
- 高效推理设计:在保持高准确率的同时显著降低计算需求
🌍 广泛的多语言支持
支持 109 种语言,覆盖全球主要语言体系:
- 主流语言:中文、英文、日文、韩文、拉丁文
- 特殊文字系统:俄语(西里尔字母)、阿拉伯语、印地语(天城文)、泰语
- 历史文献:支持手写文本和历史文献识别
🏆 SOTA 级别性能表现
在多个权威基准测试中达到最先进性能:
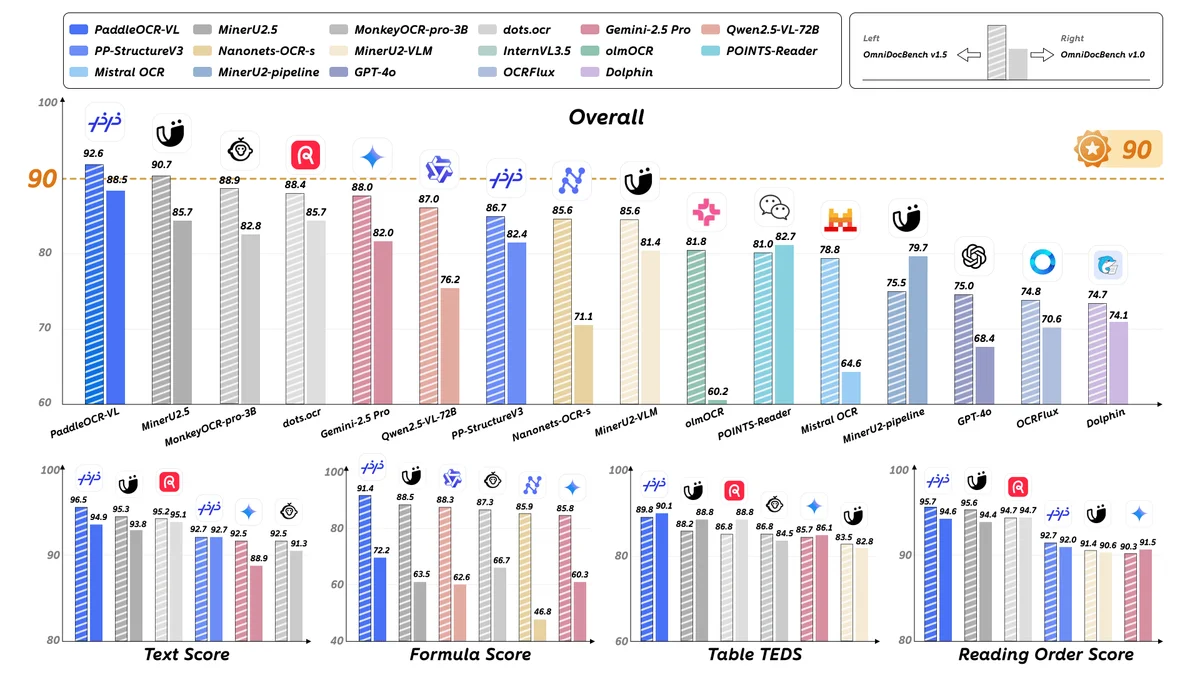
- 页面级文档解析:在 OmniDocBench v1.5 和 v1.0 上均达到 SOTA
- 元素级识别:文本、表格、公式、图表识别全面领先
- 多场景适应:从学术论文到商业文档,从印刷体到手写体
技术架构深度解析
视觉编码器设计
PaddleOCR-VL 采用 NaViT 风格的动态分辨率视觉编码器,这种设计带来了几个关键优势:
- 自适应分辨率处理:根据输入图像的复杂度动态调整处理分辨率
- 高效特征提取:针对文档图像的特点优化特征提取流程
- 多尺度信息融合:能够同时捕获细节信息和全局布局
语言模型集成
基于 ERNIE-4.5-0.3B 的轻量级语言模型提供:
- 上下文理解:理解文档的语义和结构信息
- 多语言生成:支持 109 种语言的文本输出
- 格式化输出:能够生成结构化的文档解析结果
性能表现详解
📊 页面级文档解析
在 OmniDocBench 基准测试中的表现:
🎯 元素级识别能力
文本识别
- 多文档类型:支持书籍、论文、报告等各类文档
- 多语言混合:能够处理多语言混合的复杂文档
- 低编辑距离:在所有测试文字体系中均达到最低编辑距离
表格识别
- 多样化表格类型:完整边框、部分边框、无边框表格
- 复杂结构支持:合并单元格、嵌套表格、列表格式
- 质量适应性:支持低质量图像和带水印的表格
公式识别
- 多种公式类型:印刷公式、手写公式、复杂数学表达式
- 高精度输出:LaTeX 格式的精确公式表示
- 场景适应:从教科书到学术论文的各种场景
图表识别
支持 11 种主要图表类型:
- 柱状图、折线图、饼图、散点图
- 面积图、气泡图、直方图
- 堆叠图表、混合图表等
推理部署性能
🚀 多线程异步执行
PaddleOCR-VL 采用了优化的推理工作流程:
- 数据加载阶段:PDF 页面渲染为图像
- 布局模型处理:文档布局分析和元素定位
- VLM 推理阶段:视觉语言模型进行内容识别
每个阶段在独立线程中运行,通过队列进行数据传输,实现高效的并发执行。
📈 性能基准
在单个 NVIDIA A100 GPU 上处理 512 个 PDF 文件的性能表现:
- 处理速度:平均每页 0.8 秒
- 内存占用:峰值 GPU 内存使用 < 8GB
- 吞吐量:每小时可处理 4500+ 页面
快速使用指南
🛠️ 环境准备
首先安装 PaddlePaddle 和 PaddleOCR:
       # 安装 PaddlePaddle GPU 版本
python -m pip install paddlepaddle-gpu==3.2.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/

# 安装 PaddleOCR 文档解析版本
python -m pip install -U "paddleocr[doc-parser]"

# 安装 safetensors 依赖
python -m pip install https://paddle-whl.bj.bcebos.com/nightly/cu126/safetensors/safetensors-0.6.2.dev0-cp38-abi3-linux_x86_64.whl注意:Windows 用户请使用 WSL 或 Docker 容器。PaddleOCR-VL 目前不支持 CPU 或 ARM 架构。
GPU 硬件要求
运行 PaddleOCR-VL 对 GPU 硬件有以下要求:
- GPU 显存:推荐 8GB 以上显存
- CUDA 版本:支持 CUDA 11.2+
- 显卡型号:NVIDIA GTX 1060 及以上
- 特殊说明:如果使用 NVIDIA 50 系列显卡(计算能力 >= 12),需要安装特定版本的 FlashAttention
⚡ 命令行快速体验
使用单条命令快速测试 PaddleOCR-VL:
       # 基础使用
paddleocr doc_parser -i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/paddleocr_vl_demo.png

# 启用文档方向分类
paddleocr doc_parser -i ./paddleocr_vl_demo.png --use_doc_orientation_classify True

# 启用文档去扭曲模块
paddleocr doc_parser -i ./paddleocr_vl_demo.png --use_doc_unwarping True

# 禁用布局检测
paddleocr doc_parser -i ./paddleocr_vl_demo.png --use_layout_detection False
🐍 Python API 集成
在实际项目中,通常需要通过代码集成模型。只需几行代码即可完成推理:
基础图像处理
       from paddleocr import PaddleOCRVL

# 初始化 PaddleOCR-VL 管道
pipeline = PaddleOCRVL()

# 可选配置
# pipeline = PaddleOCRVL(use_doc_orientation_classify=True)  # 启用文档方向分类
# pipeline = PaddleOCRVL(use_doc_unwarping=True)           # 启用文档去扭曲
# pipeline = PaddleOCRVL(use_layout_detection=False)       # 禁用布局检测

# 执行预测
output = pipeline.predict("./paddleocr_vl_demo.png")

# 处理结果
for res in output:
    res.print()  # 打印结构化预测输出
    res.save_to_json(save_path="output")      # 保存为 JSON 格式
    res.save_to_markdown(save_path="output")  # 保存为 Markdown 格式
PDF 文档处理
对于 PDF 文件,每页会单独处理并生成独立的 Markdown 文件。如果需要将整个 PDF 转换为单个 Markdown 文件:
       from pathlib import Path
from paddleocr import PaddleOCRVL

input_file = "./your_pdf_file.pdf"
output_path = Path("./output")

# 初始化管道
pipeline = PaddleOCRVL()

# 处理 PDF
output = pipeline.predict(input=input_file)

# 收集所有页面的 Markdown 内容
markdown_list = []
markdown_images = []

for res in output:
    md_info = res.markdown
    markdown_list.append(md_info)
    markdown_images.append(md_info.get("markdown_images", {}))

# 合并所有页面的 Markdown 内容
markdown_texts = pipeline.concatenate_markdown_pages(markdown_list)

# 保存合并后的 Markdown 文件
mkd_file_path = output_path / f"{Path(input_file).stem}.md"
mkd_file_path.parent.mkdir(parents=True, exist_ok=True)

with open(mkd_file_path, "w", encoding="utf-8") as f:
    f.write(markdown_texts)

# 保存图像文件
for item in markdown_images:
    if item:
        for path, image in item.items():
            file_path = output_path / path
            file_path.parent.mkdir(parents=True, exist_ok=True)
            image.save(file_path)
使用推理加速框架提升性能
默认配置下的推理性能可能无法满足生产环境要求。PaddleOCR 支持通过 vLLM 和 SGLang 等推理加速框架来提升 VLM 推理性能。
🐳 Docker 快速部署
PaddleOCR 提供了 Docker 镜像来快速启动 vLLM 推理服务:
基础启动
       docker run \
  -it \
  --rm \
  --gpus all \
  --network host \
  ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/paddlex-genai-vllm-server
自定义配置启动
       docker run \
  -it \
  --rm \
  --gpus all \
  --network host \
  ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/paddlex-genai-vllm-server \
  paddlex_genai_server --model_name PaddleOCR-VL-0.9B --host 0.0.0.0 --port 8118 --backend vllm
NVIDIA 50 系列显卡支持
如果使用 NVIDIA 50 系列显卡,需要先安装特定版本的 FlashAttention:
       docker run \
  -it \
  --rm \
  --gpus all \
  --network host \
  ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/paddlex-genai-vllm-server \
  /bin/bash -c "python -m pip install flash-attn==2.8.3 && paddlex_genai_server --model_name PaddleOCR-VL-0.9B --backend vllm --port 8118"
⚙️ 本地安装推理加速框架
由于推理加速框架可能与 PaddlePaddle 框架存在依赖冲突,建议在虚拟环境中安装:
       # 创建虚拟环境
python -m venv .venv

# 激活环境
source .venv/bin/activate  # Linux/Mac
# .venv\Scripts\activate     # Windows

# 安装 PaddleOCR
python -m pip install "paddleocr[doc-parser]"

# 安装推理加速服务依赖(vLLM)
paddleocr install_genai_server_deps vllm

# 或安装 SGLang
# paddleocr install_genai_server_deps sglang
启动推理加速服务
       # NVIDIA 50 系列显卡需要先安装 FlashAttention
python -m pip install flash-attn==2.8.3

# 启动 vLLM 服务
paddlex_genai_server --model_name PaddleOCR-VL-0.9B --backend vllm --port 8118
客户端调用
启动推理服务后,配置 PaddleOCR 管道调用推理服务:
       from paddleocr import PaddleOCRVL

# 配置使用推理加速服务
pipeline = PaddleOCRVL(
    vl_rec_backend="server",
    vl_rec_server_url="http://localhost:8118",
    vl_rec_max_concurrency="4"
)

# 执行预测
output = pipeline.predict("./your_image.png")
for res in output:
    res.print()
🔧 参数配置说明
主要参数
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
use_doc_orientation_classify | bool | False | 是否启用文档方向分类 |
use_doc_unwarping | bool | False | 是否启用文档去扭曲模块 |
use_layout_detection | bool | True | 是否启用布局检测 |
use_chart_recognition | bool | False | 是否启用图表识别 |
device | str | ”gpu:0” | 设备选择(cpu/gpu:0/npu:0等) |
layout_threshold | float | 0.5 | 布局检测阈值 |
输入格式支持
- 图像文件:支持常见图像格式(JPG、PNG、BMP 等)
- PDF 文件:支持多页 PDF 文档
- 网络 URL:支持在线图像和 PDF 链接
- 目录路径:批量处理目录中的图像文件
- NumPy 数组:直接处理图像数据
使用建议与最佳实践
🔧 部署建议
-
硬件要求
- 推荐使用 GPU 加速(NVIDIA A100/V100/RTX 系列)
- 最低 8GB GPU 内存
- 支持 CPU 推理(性能会有所降低)
-
软件环境
- Python 3.8+
- PaddlePaddle 框架
- CUDA 11.2+(GPU 版本)
-
性能优化
- 批量处理可显著提升吞吐量
- 合理设置图像分辨率以平衡精度和速度
- 使用多线程异步处理提升效率
📝 使用技巧
- 图像预处理:确保输入图像清晰度和对比度
- 语言设置:根据文档主要语言选择合适的语言模型
- 输出格式:根据需求选择 JSON、Markdown 或其他结构化格式
与竞品对比
| 特性对比 | PaddleOCR-VL | GPT-4V | Claude-3 | Gemini Pro |
|---|---|---|---|---|
| 模型大小 | 0.9B | ~1.7T | ~175B | ~540B |
| 语言支持 | 109种 | 50+ | 95+ | 100+ |
| 专业文档 | ✅ 专门优化 | ❌ 通用 | ❌ 通用 | ❌ 通用 |
| 部署成本 | ✅ 低 | ❌ 高 | ❌ 高 | ❌ 高 |
| 离线使用 | ✅ 支持 | ❌ 仅在线 | ❌ 仅在线 | ❌ 仅在线 |
总结
PaddleOCR-VL 作为百度在文档解析领域的最新力作,以其紧凑的模型规模、强大的多语言支持和 SOTA 级别的性能表现,为文档数字化和智能处理提供了新的解决方案。
核心优势总结:
- 🎯 高效紧凑:0.9B 参数实现 SOTA 性能
- 🌍 多语言支持:覆盖 109 种语言
- 🏆 全面领先:在文本、表格、公式、图表识别全面领先
- ⚡ 部署友好:支持离线部署,成本可控
无论是学术研究、商业应用还是政务服务,PaddleOCR-VL 都能为您的文档处理需求提供强有力的技术支撑。随着技术的不断演进和生态的完善,相信它将在更多场景中发挥重要作用。
参考资源
更多文章