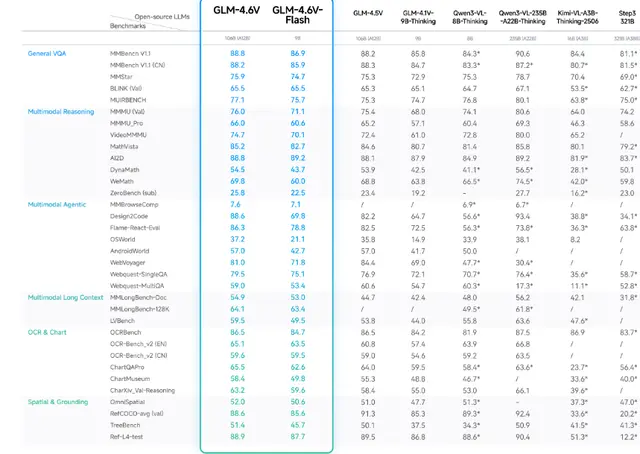
GLM-4.6V 开源多模态 AI 模型下载使用教程【免费 106B 参数 | 图像识别 | 文档理解 | 视频分析】
GLM-4.6V 免费开源多模态 AI 大模型完整教程。支持图像识别、OCR文字提取、PDF文档理解、视频分析等功能,128K超长上下文,106B/9B 两个版本可选,支持本地部署和云端调用,包含下载安装、API使用、实战案例等详细说明
GLM-4.6V 多模态 AI AI 模型
17 min read

5 篇文章
比较 OCR 文字识别工具与模型,查找文档、表格、公式识别及本地部署教程。
先区分扫描文档、原生 PDF 和自然场景图片,再按语言、版面复杂度及硬件选择方案。除了识别准确率,也应验证阅读顺序、表格与公式的输出质量。
GLM-4.6V 免费开源多模态 AI 大模型完整教程。支持图像识别、OCR文字提取、PDF文档理解、视频分析等功能,128K超长上下文,106B/9B 两个版本可选,支持本地部署和云端调用,包含下载安装、API使用、实战案例等详细说明
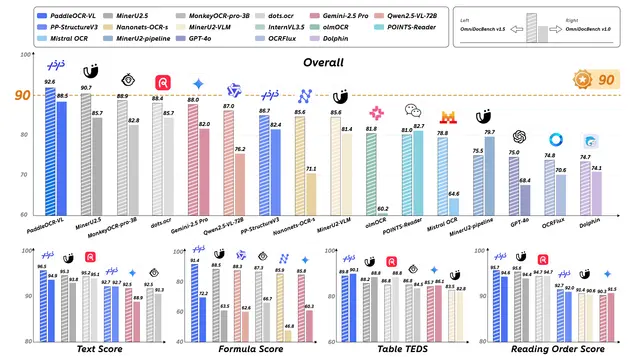
PaddleOCR-VL 完整使用教程:百度最新 0.9B 参数文档解析 AI 模型,支持 109 种语言 OCR 识别,文本表格公式图表一键解析,提供 Docker 部署和 Python API 集成方案,SOTA 性能超越 GPT-4V。
vLLM 现已原生支持小红书 dots.ocr 模型,提供免费商用的多语言 OCR 功能。本教程将指导您如何通过两行命令快速部署,轻松实现对包含文本、表格、公式在内的100多种语言文档的高效解析与识别。
IBM Research发布的轻量级视觉语言模型SmolDocling,仅256M参数,支持全文档OCR和多模态处理,每页处理速度0.35秒,能在消费级显卡上运行,支持文字、公式、代码、图表等多种元素的识别和处理。
详细的MinerU使用教程,从基础概念到高级应用,包含在线体验和本地部署方法。支持从PDF文档中智能提取文本、图片、表格和数学公式,具备多语言OCR和结构化转换能力。适用于学术研究、数据分析等场景的开源工具,让文档数据提取变得简单高效。