GLM-OCR:0.9B参数登顶OmniDocBench,智谱AI开源最强文档OCR模型
智谱AI发布GLM-OCR,0.9B参数的多模态OCR模型,OmniDocBench V1.5排名第一(94.62分)。支持复杂文档解析、公式识别、表格提取,推理速度1.86页/秒,完全开源支持vLLM/SGLang/Ollama部署。
本文发布于 227 天前,内容可能已过时,请注意甄别。
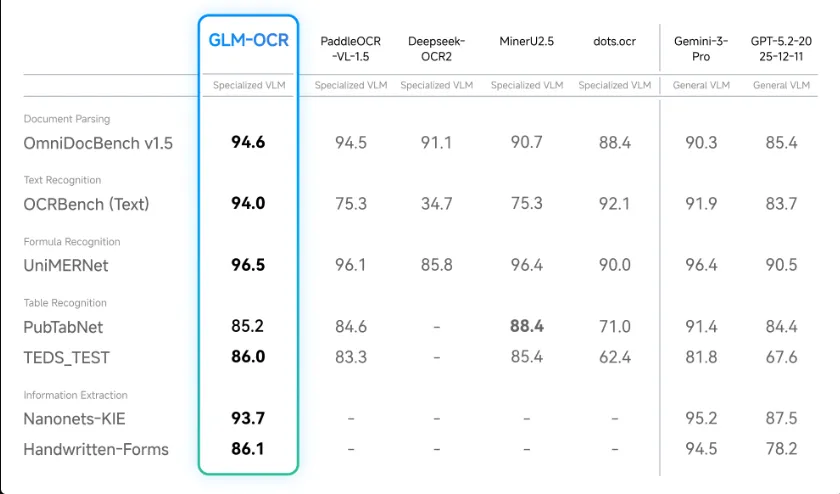
智谱AI正式开源 GLM-OCR,这是一款专为复杂文档理解设计的多模态OCR模型。凭借仅 0.9B 参数,GLM-OCR 在 OmniDocBench V1.5 上取得 94.62 分,位列第一名,并在公式识别、表格识别、信息提取等主流文档理解基准上达到业界领先水平。
一句话总结:小模型,大能力
GLM-OCR 用不到 1B 的参数量,做到了:
- 📊 OmniDocBench V1.5 第一名(94.62 分)
- ⚡ 推理速度快:PDF 文档 1.86 页/秒,图片 0.67 张/秒
- 🎯 实战优化:复杂表格、代码文档、印章等真实场景表现出色
- 🔓 完全开源:MIT 协议,支持 vLLM、SGLang、Ollama 部署
核心技术亮点
架构设计
GLM-OCR 基于 GLM-V 编码器-解码器架构,包含三大核心组件:
| 组件 | 技术方案 | 作用 |
|---|---|---|
| 视觉编码器 | CogViT(大规模图文预训练) | 提取图像特征 |
| 跨模态连接器 | 轻量级设计 + 高效token降采样 | 视觉-语言对齐 |
| 语言解码器 | GLM-0.5B | 生成文本输出 |
训练创新
1. Multi-Token Prediction (MTP) 损失
- 提升训练效率
- 增强识别准确性
2. 稳定的全任务强化学习
- 改善泛化能力
- 适应多样化文档布局
3. 两阶段处理流程
- 第一阶段:基于 PP-DocLayout-V3 的布局分析
- 第二阶段:并行识别处理
性能表现:数据说话
文档解析与信息提取基准
| 基准测试 | GLM-OCR | 说明 |
|---|---|---|
| OmniDocBench V1.5 | 94.62 🏆 | 综合文档理解,排名第一 |
| 公式识别 | SOTA | 数学公式、LaTeX 识别 |
| 表格识别 | SOTA | 复杂表格结构提取 |
| 信息提取 | SOTA | 结构化数据抽取 |
真实场景表现
GLM-OCR 针对实际业务场景进行了专门优化:
| 场景类型 | 表现 | 优势 |
|---|---|---|
| 复杂表格 | 优秀 | 跨页表格、嵌套表格 |
| 代码文档 | 优秀 | 代码块、语法高亮 |
| 印章识别 | 鲁棒 | 圆形、椭圆、不规则印章 |
| 混合布局 | 鲁棒 | 图文混排、多栏布局 |
速度对比:快得惊人
在相同硬件和测试条件下(单副本、单并发),GLM-OCR 的吞吐量显著领先:
| 输入类型 | GLM-OCR 速度 | 对比优势 |
|---|---|---|
| PDF 文档 | 1.86 页/秒 | 明显快于同类模型 |
| 图片 | 0.67 张/秒 | 高效处理 |
为什么这么快?
- 仅 0.9B 参数,推理开销小
- 优化的模型架构
- 支持高性能推理框架(vLLM、SGLang)
使用方式:多种部署选择
方式一:vLLM(推荐用于生产环境)
       # 安装
pip install -U vllm --extra-index-url https://wheels.vllm.ai/nightly

# 或使用 Docker
docker pull vllm/vllm-openai:nightly

# 启动服务
pip install git+https://github.com/huggingface/transformers.git
vllm serve zai-org/GLM-OCR \
  --allowed-local-media-path / \
  --port 8080
方式二:SGLang(高性能推理)
       # Docker 方式
docker pull lmsysorg/sglang:dev

# 或从源码安装
pip install git+https://github.com/sgl-project/sglang.git#subdirectory=python

# 启动服务
pip install git+https://github.com/huggingface/transformers.git
python -m sglang.launch_server \
  --model zai-org/GLM-OCR \
  --port 8080
方式三:Ollama(最简单)
       # 下载 Ollama: https://ollama.com/download

# 一键运行
ollama run glm-ocr
Ollama 小技巧:直接拖拽图片到终端即可识别!
       ollama run glm-ocr
Text Recognition: ./image.png
方式四:Transformers(开发调试)
       from transformers import AutoProcessor, AutoModelForImageTextToText
import torch

MODEL_PATH = "zai-org/GLM-OCR"

# 构建消息
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "test_image.png"},
            {"type": "text", "text": "Text Recognition:"}
        ],
    }
]

# 加载模型
processor = AutoProcessor.from_pretrained(MODEL_PATH)
model = AutoModelForImageTextToText.from_pretrained(
    MODEL_PATH,
    torch_dtype="auto",
    device_map="auto",
)

# 推理
inputs = processor.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt"
).to(model.device)

inputs.pop("token_type_ids", None)
generated_ids = model.generate(**inputs, max_new_tokens=8192)
output_text = processor.decode(
    generated_ids[0][inputs["input_ids"].shape[1]:],
    skip_special_tokens=False
)
print(output_text)
支持的任务类型
1. 文档解析(Document Parsing)
从文档中提取原始内容:
| 任务 | Prompt | 用途 |
|---|---|---|
| 文本识别 | Text Recognition: | 提取纯文本 |
| 公式识别 | Formula Recognition: | 提取数学公式 |
| 表格识别 | Table Recognition: | 提取表格结构 |
2. 信息提取(Information Extraction)
提取结构化信息,必须使用严格的 JSON Schema:
示例:提取身份证信息
       prompt = """请按下列JSON格式输出图中信息:
{
    "id_number": "",
    "last_name": "",
    "first_name": "",
    "date_of_birth": "",
    "address": {
        "street": "",
        "city": "",
        "state": "",
        "zip_code": ""
    },
    "dates": {
        "issue_date": "",
        "expiration_date": ""
    },
    "sex": ""
}"""
⚠️ 重要提示:信息提取时,输出必须严格遵循定义的 JSON Schema,以确保下游处理兼容性。
GLM-OCR SDK:更简单的使用方式
智谱AI 提供了易用的 SDK,让 GLM-OCR 的使用更加高效便捷。
访问 GitHub 仓库 获取详细文档和示例代码。
SDK 特性:
- 🚀 一行代码调用
- 📦 简单安装
- 🔧 平滑集成到现有生产流程
- 📚 完整的文档和示例
技术对比:为什么选择 GLM-OCR?
| 特性 | GLM-OCR | 传统 OCR | 其他多模态 OCR |
|---|---|---|---|
| 参数量 | 0.9B | - | 通常 >7B |
| 推理速度 | 1.86 页/秒 | 较慢 | 较慢 |
| 复杂文档 | ✅ 优秀 | ❌ 较弱 | ✅ 良好 |
| 部署成本 | 💰 低 | 💰 低 | 💰💰 高 |
| 开源 | ✅ MIT | ❌ 多为闭源 | ⚠️ 部分开源 |
| 易用性 | ✅ 多种部署方式 | ⚠️ 一般 | ⚠️ 一般 |
适用场景
GLM-OCR 特别适合以下场景:
| 场景 | 说明 | 优势 |
|---|---|---|
| 文档数字化 | 扫描件、PDF 转文本 | 高精度、快速 |
| 票据识别 | 发票、收据、合同 | 结构化提取 |
| 学术文献 | 论文、教材、公式 | 公式识别强 |
| 表格提取 | 财务报表、数据表 | 复杂表格处理 |
| 边缘部署 | 移动端、嵌入式设备 | 参数量小 |
| 高并发服务 | API 服务、批量处理 | 推理速度快 |
开源协议与致谢
开源协议
- GLM-OCR 模型:MIT License
- PP-DocLayoutV3(文档布局分析):Apache License 2.0
使用本项目时,请遵守两个协议的要求。
致谢
GLM-OCR 的开发受到以下优秀项目的启发:
- PP-DocLayout-V3 - 文档布局分析
- PaddleOCR - OCR 工具集
- MinerU - 文档解析
社区与支持
- 🌐 官方文档:docs.z.ai/guides/vlm/glm-ocr
- 💬 Discord:加入社区
- 📱 微信群:扫描二维码加入
- 🔧 GitHub:zai-org/GLM-OCR
- 🤗 Hugging Face:zai-org/GLM-OCR
总结:小而美的 OCR 新选择
GLM-OCR 用 0.9B 的参数量证明了”小模型也能有大能力”:
✅ 性能第一:OmniDocBench V1.5 排名第一(94.62) ✅ 速度快:1.86 页/秒,适合生产环境 ✅ 真实场景优化:复杂表格、代码、印章都能搞定 ✅ 部署灵活:vLLM、SGLang、Ollama 多种选择 ✅ 完全开源:MIT 协议,商用友好
对于需要高质量文档 OCR 能力的开发者和企业来说,GLM-OCR 是一个值得尝试的新选择——既有顶级性能,又有出色的推理效率,还完全开源免费。
相关资源:
更多文章