GLM-5.3 发布:基座没换,智谱把后训练推到数十倍任务环境
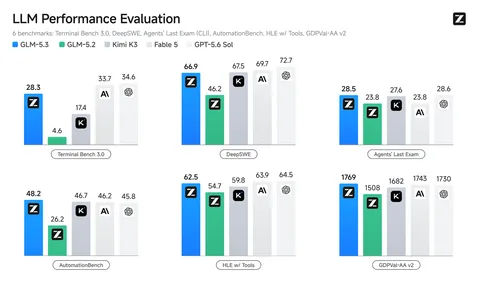
GLM-5.3 发布:不换 744B-A40B 基座,智谱把升级重点放在后训练 Scaling。模型提供 1M 上下文、128K 输出,官方公布 Terminal-Bench 3.0 为 28.3,DeepSWE v1.1 为 66.9。
本文发布于 35 天前,内容可能已过时,请注意甄别。
GLM-5.3 发布了。第一眼看参数表,可能会有点意外:这次并没有换一套更大的基座。智谱把力气用在了后训练上,想让模型不只是会写几段代码,而是真正把一项工作往下做完。
智谱称,GLM-5.3 沿用 GLM-5.2 的基座模型,却把后训练扩展到数十倍规模的长程任务环境中。模型不只做一道孤立的编程题,而是要在更接近真实工程的环境里完成发现问题、分析方案、实施、验证和交付。
目前,GLM-5.3 已在 GLM Coding Plan 全量上线。不过,官方文档也写得很清楚:模型 API 还在等待上线。想先体验,可以从 Coding Plan 进入;想把它接进自己的程序,还得再等一等。
参数没换,训练方式变了
GLM-5.3 是一款文本旗舰模型,提供 1M 上下文窗口 和 128K 最大输出,支持思考模式、流式输出、Function Calling、上下文缓存、结构化输出和 MCP。
官方没有在 GLM-5.3 页面单列参数规模,但明确说明它与 GLM-5.2 使用完全相同的基座。按 GLM-5 官方仓库对 5.2 的标注,这套 MoE 基座为 744B 总参数、40B 激活参数。
换句话说,5.3 的核心变化不是重新造一个更大的底座,而是把后训练做得更重、更久:
- 长程任务环境扩大到数十倍规模,环境类型也更丰富
- 训练周期拉长,部分任务相当于资深工程师连续数天的工作量
- 任务会接触真实计算集群、存储系统、内部文档和代码库
- 训练目标从“解题”扩展到完整的工程闭环
真正麻烦的地方也正在这里。写出第一段代码不难,难的是接下来还要读懂约束、调用工具、处理报错、跑完验证,并且在很长的上下文里别把目标忘了。GLM-5.3 想补上的,正是这段最容易“前面跑得很快,后面逐渐跑偏”的路程。
官方评测提升了多少?
智谱公布的 GLM-5.3 技术页面给出了以下公开基准成绩。
| 测试集 | GLM-5.2 | GLM-5.3 | 提升 |
|---|---|---|---|
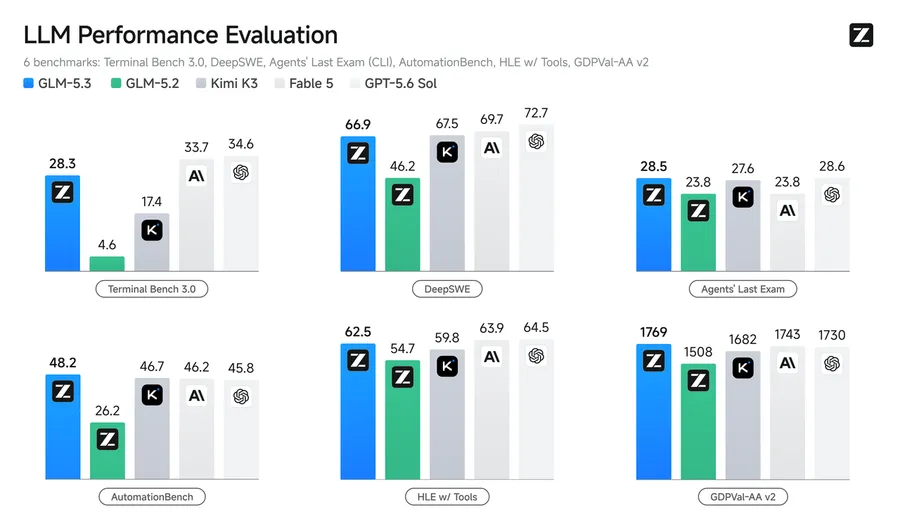
| Terminal-Bench 3.0 | 4.6 | 28.3 | +23.7 |
| DeepSWE v1.1 | 46.2 | 66.9 | +20.7 |
| Agents’ Last Exam | 23.8 | 28.5 | +4.7 |
这三个测试看的东西不太一样:Terminal-Bench 3.0 看 Agent 能不能在终端里把任务做完,DeepSWE 更贴近软件修复和实现,Agents’ Last Exam 则更考验长链路智能体任务。智谱称,GLM-5.3 在这些公开基准中位列开源模型第一,并将它的编程与智能体能力描述为“比肩 Claude Fable 5”。
智谱还给出了 GDPval-AA v2 1769 的成绩,覆盖 44 种职业场景。它看的不只是代码题,而是模型在更广泛专业工作里的完成度。
和顶尖模型同测
智谱还公布了内部编程基准 Z.ai Code Bench 的对比结果。测试环境贴近真实用户使用场景,除了任务准确率,也记录智能体完成任务时消耗的输出 Token。
| 模型 | 推理档位 | 任务准确率 | 平均输出 Token |
|---|---|---|---|
| GLM-5.3 | High | 31.4% | 约 5 万 |
| Claude Opus 4.8 | High | 29.5% | 约 12 万 |
| GLM-5.3 | Max | 34.5% | 约 7.5 万 |
| GLM-5.2 | Max | 23.4% | 约 9.6 万 |
| Claude Fable 5 | Max | 39.5% | 官方未披露 |
在 High 档位下,GLM-5.3 的准确率为 31.4%,高于 Claude Opus 4.8 的 29.5%,平均输出 Token 也从约 12 万降到约 5 万。切到 Max 档位后,GLM-5.3 达到 34.5%,Claude Fable 5 为 39.5%。
安全评测是另一个新重点
GLM-5.3 也补充了网络安全能力的评测数据。官方公布:
| 测试集 | GLM-5.2 | GLM-5.3 |
|---|---|---|
| CyberGym | 77.2% | 84.5% |
| ExploitBench | 24.4% | 54.4% |
在 CyberGym 上,官方列出的对照成绩是 Mythos 5 的 83.8% 和 GPT-5.6 Sol 的 83.6%,GLM-5.3 为 84.5%。至少从这项官方数据看,智谱确实把漏洞分析和工具链协同当成了重点训练方向。
智谱将当前优势放在漏洞利用链的前端,更深入的漏洞利用和完整攻防任务仍是下一步提升方向。
在更深入的 ExploitBench 对比中,GLM-5.3 的 54.4% 仍低于 Mythos 5 的 78.0% 和 GPT-5.6 Sol 的 76.5%。另一项 ExploitGym 则统计模型在固定时间内完成的漏洞利用任务数:GLM-5.3 在两小时和六小时内分别完成 105 项和 130 项,GLM-5.2 为 29 项和 39 项,Mythos 5 则达到 181 项和 247 项。
这组安全数据比单看 CyberGym 更完整:GLM-5.3 在漏洞发现上已经达到领先水平,但任务越深入到完整利用链,和顶尖闭源模型的差距仍然明显。
为什么这次盯住后训练?
当基础模型的分数越来越高,开发者真正感受到差别的地方,往往不再是“它会不会回答”,而是“它能不能一直做下去,并且最后交付一个能用的结果”。
拿修复一个线上问题来说,代码 Agent 得先读仓库、定位问题、改文件、跑测试、看报错,然后决定下一步怎么改。任务一长,最常见的麻烦就是前半段判断还不错,后半段开始偏离目标;或者工具调用了一大串,结果始终没有真正收敛。
GLM-5.3 用更长的任务环境和后训练周期,瞄准的就是这类“做完”的能力。智谱称,在相近 token 预算下,5.3 在完成质量、执行速度和成本之间找到了更好的平衡,并将编程体感的提升概括为约 50%。
现在如何使用?
目前,想直接试用 GLM-5.3 的用户可以从 GLM Coding Plan 进入,官方已经完成全量上线。
模型 API 尚未上线,独立权重下载和模型卡也尚未公布。价格、限额和开发者接入方式将随 API 公告更新。
最后
GLM-5.3 的看点,不是又换了一套更大的底座,而是把原来的基座放进更长、更复杂、更像真实工作的环境里反复训练。官方分数已经出现明显变化,尤其是在终端和软件工程任务上。
这次升级把方向写得很明白:智能体之间的竞争,正在从“能不能写代码”,转向“能不能把项目做完”。
来源:
更多文章