HunyuanOCR 教程:1B 参数超越 DeepSeek/PaddleOCR/Qwen 的腾讯开源 OCR 模型部署指南
HunyuanOCR 开源教程:腾讯混元 1B 参数 OCR 模型,性能全面超越 DeepSeek-OCR、PaddleOCR 和 Qwen3-VL-235B。卡证识别 92% vs DeepSeek 10%,视频字幕提取 92% vs 5%。支持 100+ 语言,提供 vLLM OpenAI API 部署完整代码。
本文发布于 297 天前,内容可能已过时,请注意甄别。
HunyuanOCR 是什么?
HunyuanOCR 是腾讯混元团队推出的一款端到端 OCR 专家级视觉语言模型(VLM)。它基于混元原生多模态架构,仅用 1B 参数就在多个行业基准测试中达到了 SOTA(最先进)水平。
这个模型最厉害的地方在于它的”端到端”理念——单条指令、单次推理就能完成复杂任务,比那些需要多个模型级联的方案效率高多了。
💡 简单来说,HunyuanOCR 就是一个小而强的 OCR 模型,能处理各种复杂的文档识别任务,还支持 100 多种语言。
核心特性与功能
💪 高效轻量架构
- 1B 参数设计:基于混元原生多模态架构和训练策略,用极少的参数量实现了 SOTA 性能
- 部署成本低:相比动辄几十上百 B 的大模型,部署门槛大大降低
- 端到端推理:单次推理完成任务,不需要复杂的级联流程
📑 全面的 OCR 能力
一个模型覆盖多种经典 OCR 任务:
- 文本检测与识别:精准定位和识别图片中的文字
- 复杂文档解析:处理包含公式、表格、图表的复杂文档
- 开放域信息提取:从卡证、票据等提取结构化信息
- 视频字幕提取:自动提取视频画面中的字幕
- 图片翻译:端到端的图片文字翻译
- 文档问答:基于文档内容进行问答
🌏 广泛的语言支持
- 支持 100+ 种语言
- 在单语言和混合语言场景下都表现出色
- 特别优化了 14 种常用小语种(德语、西班牙语、土耳其语、意大利语、俄语、法语、葡萄牙语、阿拉伯语、泰语、越南语、印尼语、马来语、日语、韩语)到中英文的翻译
系统要求
🖥️ 硬件要求
跑这个模型对硬件还是有一定要求的:
- 操作系统:Linux
- Python:3.12+(推荐)
- CUDA:12.8
- PyTorch:2.7.1
- GPU:支持 CUDA 的 NVIDIA 显卡
- 显存:80GB
- 硬盘空间:6GB
⚠️ 注意:80GB 显存的要求意味着你需要 A100 或 H100 这样的专业显卡,普通消费级显卡可能跑不动完整模型。
快速开始
🚀 使用 vLLM(推荐)
vLLM 是官方推荐的推理方式,性能更好。
安装
使用 pip:
pip install vllm --pre --extra-index-url https://wheels.vllm.ai/nightly使用 uv:
uv pip install vllm --extra-index-url https://wheels.vllm.ai/nightly模型推理
       from vllm import LLM, SamplingParams
from PIL import Image
from transformers import AutoProcessor

def clean_repeated_substrings(text):
    """清理文本中的重复子串"""
    n = len(text)
    if n < 8000:
        return text
    for length in range(2, n // 10 + 1):
        candidate = text[-length:]
        count = 0
        i = n - length

        while i >= 0 and text[i:i + length] == candidate:
            count += 1
            i -= length

        if count >= 10:
            return text[:n - length * (count - 1)]

    return text

# 加载模型
model_path = "tencent/HunyuanOCR"
llm = LLM(model=model_path, trust_remote_code=True)
processor = AutoProcessor.from_pretrained(model_path)
sampling_params = SamplingParams(temperature=0, max_tokens=16384)

# 准备输入
img_path = "/path/to/image.jpg"
img = Image.open(img_path)
messages = [
    {"role": "user", "content": [
        {"type": "image", "image": img_path},
        {"type": "text", "text": "检测并识别图片中的文字,将文本坐标格式化输出。"}
    ]}
]

# 推理
prompt = processor.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
inputs = {"prompt": prompt, "multi_modal_data": {"image": [img]}}
output = llm.generate([inputs], sampling_params)[0]
print(clean_repeated_substrings(output.outputs[0].text))
部署 OpenAI 兼容 API 服务
vLLM 还支持部署 OpenAI 兼容的 API 服务器,方便集成到现有系统中:
启动服务:
       vllm serve tencent/HunyuanOCR \
    --no-enable-prefix-caching \
    --mm-processor-cache-gb 0
使用 OpenAI 客户端调用:
       from openai import OpenAI

# 创建客户端
client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600
)

# 构建请求
messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {
                    "url": "https://example.com/your-image.png"
                }
            },
            {
                "type": "text",
                "text": (
                    "提取文档图片中正文的所有信息用 markdown 格式表示,"
                    "其中页眉、页脚部分忽略,表格用 html 格式表达,"
                    "文档中公式用 latex 格式表示,按照阅读顺序组织进行解析。"
                )
            }
        ]
    }
]

# 发送请求
response = client.chat.completions.create(
    model="tencent/HunyuanOCR",
    messages=messages,
    temperature=0.0,
)

print(f"识别结果: {response.choices[0].message.content}")
配置建议:
- 使用贪婪采样(
temperature=0.0)或低温度采样以获得最佳 OCR 性能 - OCR 任务通常不需要前缀缓存或图像复用,建议关闭这些功能以避免不必要的哈希和缓存开销
- 根据硬件能力调整
max_num_batched_tokens参数以获得更好的吞吐量
🔧 使用 Transformers
如果你更熟悉 Transformers 框架,也可以用这种方式:
安装
pip install git+https://github.com/huggingface/transformers@82a06db03535c49aa987719ed0746a76093b1ec4注意:目前 Transformers 相比 vLLM 框架有一定的性能下降,官方正在修复中。
模型推理
       from transformers import AutoProcessor
from transformers import HunYuanVLForConditionalGeneration
from PIL import Image
import torch

# 加载模型和处理器
model_name_or_path = "tencent/HunyuanOCR"
processor = AutoProcessor.from_pretrained(model_name_or_path, use_fast=False)

# 准备输入
img_path = "path/to/your/image.jpg"
image_inputs = Image.open(img_path)
messages1 = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": img_path},
            {"type": "text", "text": "检测并识别图片中的文字,将文本坐标格式化输出。"},
        ],
    }
]
messages = [messages1]

# 处理输入
texts = [
    processor.apply_chat_template(msg, tokenize=False, add_generation_prompt=True)
    for msg in messages
]
inputs = processor(
    text=texts,
    images=image_inputs,
    padding=True,
    return_tensors="pt",
)

# 加载模型并推理
model = HunYuanVLForConditionalGeneration.from_pretrained(
    model_name_or_path,
    attn_implementation="eager",
    dtype=torch.bfloat16,
    device_map="auto"
)

with torch.no_grad():
    device = next(model.parameters()).device
    inputs = inputs.to(device)
    generated_ids = model.generate(**inputs, max_new_tokens=16384, do_sample=False)

# 解码输出
if "input_ids" in inputs:
    input_ids = inputs.input_ids
else:
    input_ids = inputs.inputs

generated_ids_trimmed = [
    out_ids[len(in_ids):] for in_ids, out_ids in zip(input_ids, generated_ids)
]
output_texts = processor.batch_decode(
    generated_ids_trimmed, skip_special_tokens=True, clean_up_tokenization_spaces=False
)
print(output_texts)
应用场景与提示词
HunyuanOCR 支持多种任务,下面是常用的提示词:
📝 文本检测与识别(Spotting)
检测并识别图片中的文字,将文本坐标格式化输出。📄 文档解析(Document Parsing)
| 任务 | 提示词 |
|---|---|
| 公式识别 | 识别图片中的公式,用 LaTeX 格式表示。 |
| 表格解析 | 把图中的表格解析为 HTML。 |
| 图表解析 | 解析图中的图表,对于流程图使用 Mermaid 格式表示,其他图表使用 Markdown 格式表示。 |
| 完整文档 | 提取文档图片中正文的所有信息用 markdown 格式表示,其中页眉、页脚部分忽略,表格用 html 格式表达,文档中公式用 latex 格式表示,按照阅读顺序组织进行解析。 |
📋 通用解析
提取图中的文字。🔍 信息提取
| 任务 | 提示词 |
|---|---|
| 单字段提取 | 输出 Key 的值。 |
| 多字段提取 | 提取图片中的: [‘key1’,‘key2’, …] 的字段内容,并按照 JSON 格式返回。 |
| 字幕提取 | 提取图片中的字幕。 |
🌐 翻译
先提取文字,再将文字内容翻译为英文。若是文档,则其中页眉、页脚忽略。公式用latex格式表示,表格用html格式表示。性能评测
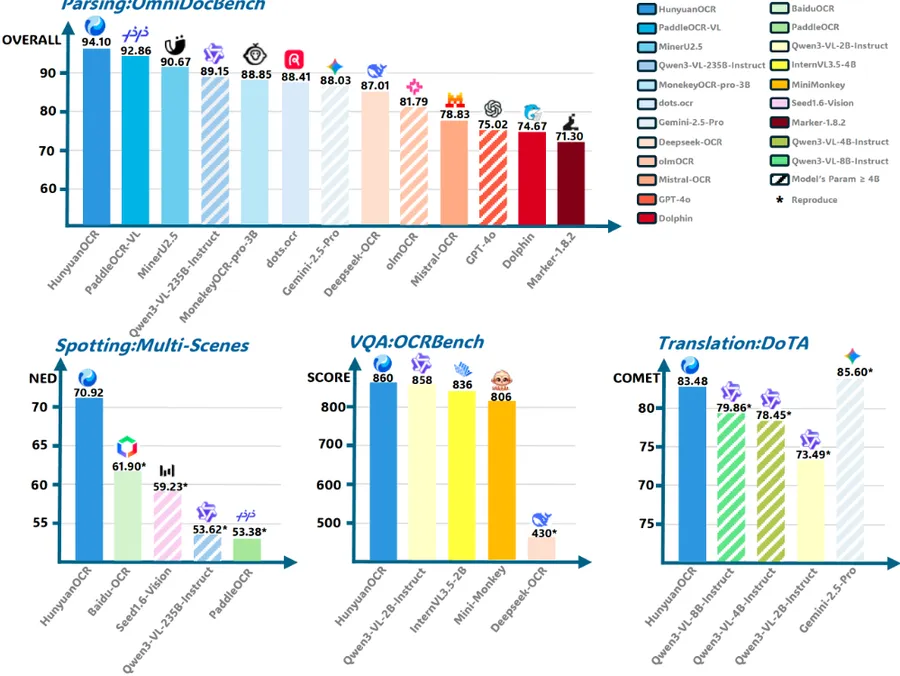
📊 文本检测识别性能
在内部基准测试中,HunyuanOCR 的整体表现:
| 模型类型 | 方法 | 整体得分 |
|---|---|---|
| 传统方法 | PaddleOCR | 53.38 |
| 传统方法 | BaiduOCR | 61.9 |
| 通用 VLM | Qwen3VL-2B-Instruct | 29.68 |
| 通用 VLM | Qwen3VL-235B-Instruct | 53.62 |
| 通用 VLM | Seed-1.6-Vision | 59.23 |
| OCR 专用 VLM | HunyuanOCR | 70.92 |
总结:HunyuanOCR 在各种场景下都取得了最佳的整体性能(70.92%),显著超越了传统 OCR 方法和通用 VLM。
📑 文档解析性能
在 OmniDocBench 和多语言内部基准测试中:
| 模型类型 | 方法 | 参数量 | OmniDocBench 整体 |
|---|---|---|---|
| 通用 VLM | Gemni-2.5-pro | - | 88.03 |
| 通用 VLM | Qwen3-VL-235B | 235B | 89.15 |
| 专用 VLM(模块化) | MinerU2.5 | 1.2B | 90.67 |
| 专用 VLM(模块化) | PaddleOCR-VL | 0.9B | 92.86 |
| 专用 VLM(端到端) | Deepseek-OCR | 3B | 87.01 |
| 专用 VLM(端到端) | dots.ocr | 3B | 88.41 |
| 专用 VLM(端到端) | HunyuanOCR | 1B | 94.10 |
总结:HunyuanOCR 在多语言文档解析方面表现卓越,在大多数类别中都达到了最低的编辑距离。
📋 信息提取与 VQA 性能
| 模型 | 卡证 | 票据 | 视频字幕 | OCRBench |
|---|---|---|---|---|
| DeepSeek-OCR | 10.04 | 40.54 | 5.41 | 430 |
| Qwen3-VL-2B-Instruct | 67.62 | 64.62 | 3.75 | 858 |
| Gemini-2.5-Pro | 80.59 | 80.66 | 53.65 | 872 |
| Qwen3-VL-235B-A22B-Instruct | 75.59 | 78.4 | 50.74 | 920 |
| HunyuanOCR | 92.29 | 92.53 | 92.87 | 860 |
总结:HunyuanOCR 在卡证/票据处理和视频字幕提取方面显著超越了更大的模型,同时在 OCRBench 上保持了有竞争力的表现。
🌐 图片翻译性能
| 方法 | 参数量 | Other2En | Other2Zh | DoTA (en2zh) |
|---|---|---|---|---|
| Gemini-2.5-Flash | - | 79.26 | 80.06 | 85.60 |
| Qwen3-VL-235B-Instruct | 235B | 73.67 | 77.20 | 80.01 |
| Qwen3-VL-2B-Instruct | 2B | 66.30 | 66.77 | 73.49 |
| HunyuanOCR | 1B | 73.38 | 73.62 | 83.48 |
总结:HunyuanOCR 仅用 1B 参数,在图片翻译任务中达到了与 Qwen3-VL-235B 相当的效果。
应用场景展示
🔤 文本检测与识别
模型能够在行级别输出文本图像中所有文字的内容和对应坐标信息,在文档、艺术字体、街景、手写、广告、发票、截图、游戏、视频等场景下都表现出色。
📚 复杂文档处理
能够将扫描或拍摄的多语言文档图像数字化,具体包括:
- 按阅读顺序组织文本内容
- 公式使用 LaTeX 格式
- 复杂表格使用 HTML 格式表达
📋 开放域信息提取
对于常见的卡证票据,可以使用标准 JSON 格式解析感兴趣的字段(如姓名/地址/公司等)。
示例提示词:
提取图片中的: ['单价', '上车时间', '发票号码', '省前缀', '总金额', '发票代码', '下车时间', '里程数'] 的字段内容,并按照 JSON 格式返回。示例输出:
       {
    "单价": "3.00",
    "上车时间": "09:01",
    "发票号码": "42609332",
    "省前缀": "陕",
    "总金额": "¥77.10元",
    "发票代码": "161002018100",
    "下车时间": "09:51",
    "里程数": "26.1km"
}
🎬 视频字幕提取
模型能够自动提取视频中的字幕,包括双语字幕。
🌍 图片文字翻译
模型能够端到端地将拍摄的小语种图片翻译成中文或英文文本格式。在 ICDAR2025 文档端到端翻译竞赛小模型赛道中获得冠军。
与其他 OCR 方案对比
| 特性 | HunyuanOCR | PaddleOCR | DeepSeek-OCR | 通用 VLM |
|---|---|---|---|---|
| 参数量 | 1B | - | 3B | 2B-235B |
| 端到端 | ✅ | ❌ | ✅ | ✅ |
| 多语言支持 | 100+ | 有限 | 有限 | 广泛 |
| 文档解析 | 优秀 | 良好 | 良好 | 一般 |
| 信息提取 | 优秀 | 一般 | 一般 | 良好 |
| 视频字幕 | 优秀 | 一般 | 差 | 一般 |
| 图片翻译 | 优秀 | 一般 | - | 良好 |
写在最后
HunyuanOCR 是腾讯混元团队在 OCR 领域的一次重要突破。它用仅 1B 的参数量,在多个任务上超越了参数量大得多的模型,充分体现了”小而精”的设计理念。
主要优点:
- 🎯 参数高效:1B 参数实现 SOTA 性能,部署成本低
- 🚀 端到端:单次推理完成任务,效率高
- 🌏 多语言:支持 100+ 种语言,覆盖面广
- 📑 功能全面:文本识别、文档解析、信息提取、翻译一应俱全
- ⚡ 性能强劲:在多个基准测试中领先
需要注意的地方:
- 💾 显存要求高:需要 80GB 显存,普通消费级显卡难以运行
- 🐧 仅支持 Linux:目前只支持 Linux 系统
如果你有合适的硬件条件,HunyuanOCR 绝对是目前最值得尝试的开源 OCR 模型之一。
参考资源
更多文章