GLM-4.6V 开源多模态 AI 模型下载使用教程【免费 106B 参数 | 图像识别 | 文档理解 | 视频分析】
GLM-4.6V 免费开源多模态 AI 大模型完整教程。支持图像识别、OCR文字提取、PDF文档理解、视频分析等功能,128K超长上下文,106B/9B 两个版本可选,支持本地部署和云端调用,包含下载安装、API使用、实战案例等详细说明
本文发布于 284 天前,内容可能已过时,请注意甄别。
GLM-4.6V 简介
GLM-4.6V 是 智谱 于 近日 式发布并开源的新一代多模态大语言模型,属于 GLM-V 系列模型家族。该模型在训练中将上下文窗口扩展到 128K tokens,在同等参数规模的模型中实现了视觉理解和推理的 SOTA(State-of-the-Art)性能。
核心突破:GLM-4.6V 首次在多模态模型中集成了**原生函数调用(Native Function Calling)**能力。这一创新有效地在”视觉感知”和”可执行动作”之间架起桥梁,为多模态智能体在真实业务场景中的应用提供了统一的技术基础。
传统问题:传统 LLM 的工具使用通常依赖纯文本,在处理图像、视频或复杂文档时需要多次中间转换,这可能导致信息丢失并增加系统复杂性。
GLM-4.6V 的解决方案:
- 多模态输入:图像、截图和文档页面可以直接作为工具参数传递,无需预先转换为文本描述,从而避免信息丢失并大大简化流程
- 多模态输出:模型可以视觉理解工具返回的结果(如搜索结果、统计图表、渲染的网页截图或检索的产品图片),并将其纳入后续推理链和最终输出
这种原生支持使 GLM-4.6V 能够完成从感知到理解再到执行的完整闭环,实现复杂任务,如富文本内容创作和视觉网络搜索。
模型版本
GLM-4.6V 系列包含两个版本:
| 版本 | 参数规模 | 适用场景 | 特点 |
|---|---|---|---|
| GLM-4.6V | 106B | 云端和高性能集群场景 | 基础模型,性能强大 |
| GLM-4.6V-Flash | 9B | 本地部署和低延迟应用 | 轻量级模型,快速推理 |
较大的模型拥有 1060 亿参数,而 Flash 版本拥有 90 亿参数,为不同应用场景提供了灵活的选择。
核心特性
GLM-4.6V 在同等参数规模的模型中实现了主要多模态基准测试的 SOTA 性能,并引入了以下关键特性:
1. 原生多模态函数调用 (Native Multimodal Function Calling)
GLM-4.6V 实现了原生的视觉驱动工具使用能力。图像、截图和文档页面可以直接作为工具输入传递,无需文本转换。同时,视觉输出(如图表、搜索图像、渲染页面)也能被解释并整合到推理链中,从感知到理解再到执行,形成完整闭环。
实际应用场景:
- 将产品截图直接传递给价格比对工具
- 把设计稿图片直接发送给代码生成工具
- 将扫描文档直接传给信息提取 API
2. 交错图文内容生成 (Interleaved Image-Text Content Generation)
支持从复杂的多模态输入生成高质量的混合媒体内容。GLM-4.6V 可以接收包含文档、用户输入和工具检索图像的多模态上下文,并合成连贯的、交错的图文内容。在生成过程中,模型可以主动调用搜索和检索工具来收集和整理额外的文本和视觉素材,生成丰富的、视觉基础扎实的内容。
3. 多模态文档理解 (Multimodal Document Understanding)
GLM-4.6V 可以处理多达 128K tokens 的多文档或长文档输入,直接将格式丰富的页面作为图像进行解释。模型能够联合理解文本、布局、图表、表格和图形,实现对复杂图像密集型文档的准确理解,无需事先转换为纯文本。
支持的文档类型:
- PDF 文档(合同、报告、论文)
- Excel 表格和财务报表
- 包含复杂图表的演示文稿
- 混合格式的技术文档
4. 前端复制与视觉编辑 (Frontend Replication & Visual Editing)
从 UI 截图重建像素精确的 HTML/CSS,并支持自然语言驱动的编辑。模型能够视觉检测布局、组件和样式,生成干净的代码,并通过简单的用户指令应用迭代的视觉修改。
典型用例:
- 从设计稿自动生成前端代码
- 根据截图还原网页布局
- 通过自然语言描述修改 UI 样式
性能表现
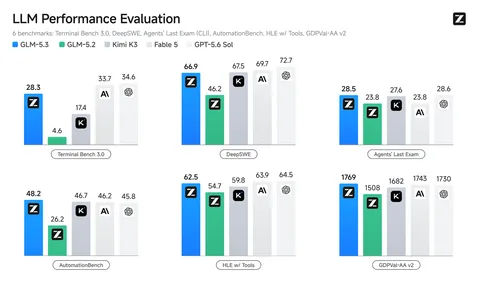
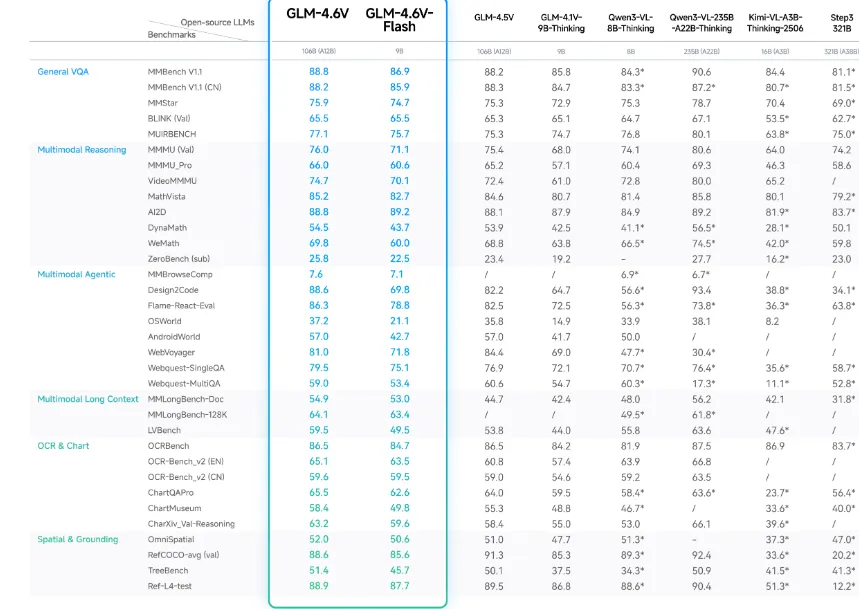
GLM-4.6V 在超过 20 个主流多模态基准测试中进行了评估,涵盖通用 VQA、图表理解、OCR、STEM 推理、前端复制和多模态智能体等领域。
主要基准测试结果
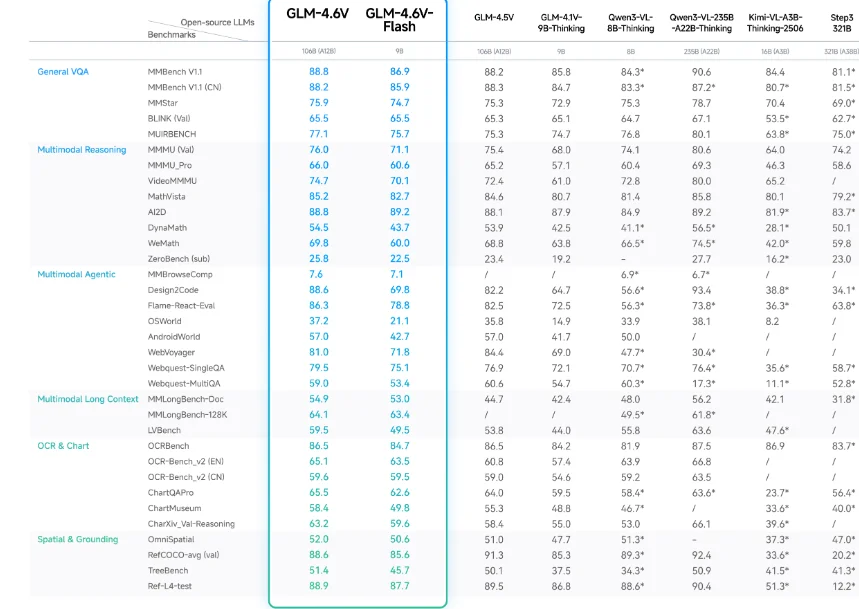
| 基准测试 | GLM-4.6V | 对比模型 | 说明 |
|---|---|---|---|
| MathVista | 88.2 | 81.4 (Qwen3-VL-8B) | 数学视觉理解 |
| WebVoyager | 81.0 | 68.4 (Qwen3-VL-8B) | 智能体导航能力 |
| Ref-L4-test | 88.9 | 89.5 (GLM-4.5V) | 空间定位 |
性能亮点
- 通用 VQA 和多模态推理:在 MMBench、MMStar、MMMU、MathVista、AI2D 等基准测试中表现稳定强劲
- 多模态智能体评估:在 Design2Code、Flame-React-Eval、WebVoyager、WebQuest、AndroidWorld、OSWorld 等任务中表现出色
- OCR 和图表理解:在 OCRBench、OCR-Bench v2(中英文)、ChartQA、ChartMuseum 等测试中展现强大的视觉文本识别能力
- 长上下文理解:在 MMLongBench-Doc、MMLongBench-128K、LVBench 等长文档任务中优于更大参数的模型
GLM-4.6V (106B) 在同等参数规模的开源模型中,在 MMBench、MathVista、MMLongBench、ChartQAPro、RefCOCO、TreeBench 等基准上达到或接近 SOTA 水平。
定价
GLM-4.6V 的 API 调用定价为:
- 输入:$0.30 / 1M tokens
- 输出:$0.90 / 1M tokens
快速开始
环境安装
使用 SGLang(推荐用于视频理解任务):
       pip install sglang>=0.5.6.post1
pip install nvidia-cudnn-cu12==9.16.0.29
sudo apt update
sudo apt install ffmpeg
使用 vLLM:
       pip install vllm>=0.12.0
pip install transformers>=5.0.0rc0
Transformers 快速示例
以下是使用 Transformers 库加载和运行 GLM-4.6V 的完整示例:
       from transformers import AutoProcessor, Glm4vMoeForConditionalGeneration
import torch

MODEL_PATH = "zai-org/GLM-4.6V"

# 准备输入消息(支持图像和文本)
messages = [
    {
        "role": "user",
        "content": [
            {
                "type": "image",
                "url": "https://upload.wikimedia.org/wikipedia/commons/f/fa/Grayscale_8bits_palette_sample_image.png"
            },
            {
                "type": "text",
                "text": "describe this image"
            }
        ],
    }
]

# 加载处理器和模型
processor = AutoProcessor.from_pretrained(MODEL_PATH)
model = Glm4vMoeForConditionalGeneration.from_pretrained(
    pretrained_model_name_or_path=MODEL_PATH,
    torch_dtype="auto",
    device_map="auto",
)

# 处理输入
inputs = processor.apply_chat_template(
    messages,
    tokenize=True,
    add_generation_prompt=True,
    return_dict=True,
    return_tensors="pt"
).to(model.device)

inputs.pop("token_type_ids", None)

# 生成输出
generated_ids = model.generate(**inputs, max_new_tokens=8192)
output_text = processor.decode(
    generated_ids[0][inputs["input_ids"].shape[1]:],
    skip_special_tokens=False
)

print(output_text)
vLLM 部署
使用 vLLM 部署 GLM-4.6V 服务器:
       vllm serve zai-org/GLM-4.6V \
  --tensor-parallel-size 4 \
  --tool-call-parser glm45 \
  --reasoning-parser glm45 \
  --enable-auto-tool-choice \
  --served-model-name glm-4.6v \
  --allowed-local-media-path / \
  --mm-encoder-tp-mode data \
  --mm_processor_cache_type shm
推荐推理参数
为了复现官方排行榜结果,推荐使用以下解码参数:
       {
    "top_p": 0.6,
    "top_k": 2,
    "temperature": 0.8,
    "repetition_penalty": 1.1,
    "max_generate_tokens": 16384  # 16K
}说明:
- 使用 vLLM 作为推理后端以获得最佳性能
- 对于视频任务,推荐使用 SGLang 以获得更快和更可靠的性能
- 思考模式(thinking mode)在 vLLM 和 SGLang 中默认启用,可通过
extra_body设置禁用
技术实现
模型架构
GLM-4.6V 使用 Glm4vMoeForConditionalGeneration 类,这是一个混合专家(Mixture of Experts, MoE)架构的多模态条件生成模型。模型完全集成在 Transformers 库中(需要 transformers>=5.0.0rc0)。
核心技术创新
1. 模型架构与长序列建模
GLM-4.6V 将训练上下文窗口扩展到 128K tokens,在高信息密度场景中实现有效的跨模态依赖建模。为了释放这一潜力,官方在大规模长上下文图文数据上进行了系统的持续预训练。
技术要点:
- 借鉴 Glyph 的视觉-语言压缩对齐思想
- 使用大规模交错语料增强视觉编码与语言语义之间的协同作用
- 实现视觉编码器与 128K 上下文长度的对齐
2. 世界知识增强
在预训练期间引入了十亿级多模态感知和世界知识数据集,涵盖多层次的概念体系(百科知识)。
效果提升:
- 不仅提高了基本视觉感知能力
- 显著提升了跨模态问答任务的准确性和完整性
- 增强了模型对真实世界概念的理解
3. 智能体数据合成与 MCP 扩展
GLM-4.6V 利用大规模合成数据进行智能体训练。为支持复杂的多模态场景,官方扩展了广泛使用的模型上下文协议(Model Context Protocol, MCP):
基于 URL 的多模态处理:
- 使用 URL 来标识传递给工具和从工具返回的多模态内容
- 解决了文件大小和格式的限制
- 允许在多图像上下文中精确操作特定图像
交错输出机制:
- 实现了混合文本-图像输出的端到端机制
- 采用”草稿 → 图像选择 → 最终润色”框架
- 模型自主调用图像裁剪或搜索工具,将相关视觉元素插入生成的文本
- 确保高度的相关性和可读性
4. 多模态智能体的强化学习(RL)
将工具调用行为纳入通用强化学习(RL)目标。这使得模型在复杂工具链中的任务规划、指令遵循和格式遵守能力得到对齐。
视觉反馈循环:
- 探索了”视觉反馈循环”机制
- 模型可以根据视觉结果调整后续行为
- 提升了多模态任务的执行准确性
推理部署
模型支持多种部署方式:
- Hugging Face Transformers:标准的模型加载和推理,适合研究和原型开发
- vLLM:高性能推理后端,优化吞吐量,适合生产环境
- SGLang:专为视频理解任务优化,提供更快的推理速度
- 本地部署:GLM-4.6V-Flash (9B) 版本支持在本地硬件上部署,降低硬件要求
API 调用
GLM-4.6V 兼容 OpenAI API 协议,支持标准的聊天完成接口。详细使用方法请参考 Z.ai 开发者文档。
四大核心能力场景
根据官方介绍,GLM-4.6V 在以下四个核心场景中表现出色:
1. 富文本内容理解与创作
GLM-4.6V 可以接受各种类型的多模态输入(论文、报告或幻灯片),并以端到端的方式自动生成高质量、结构化的图文交错内容。
关键能力:
- 复杂文档理解:准确理解包含文本、图表、图形、表格和公式的文档中的多模态信息
- 视觉工具调用:在生成过程中,模型可以自主调用工具从源多模态上下文中裁剪关键视觉元素
- 视觉审核与组合:模型对候选图像执行”视觉审核”以评估相关性和质量,过滤掉噪声,并精心组合所有相关的文本和视觉内容,生成结构化的、图文交错的文章,可直接用于社交媒体或知识库
实际应用:
- 从学术论文自动生成图文并茂的总结文章
- 将复杂报告转换为易于阅读的多媒体内容
- 自动提取演示文稿中的关键视觉元素并重新组织
2. 视觉网络搜索
GLM-4.6V 提供端到端的多模态搜索和分析工作流程,使模型能够无缝地从视觉感知到在线检索、推理,再到最终答案。
工作流程:
-
意图识别与搜索规划
- GLM-4.6V 识别用户的搜索意图并确定需要哪些信息
- 自主触发适当的搜索工具(如文本到图像搜索、图像到文本搜索)以检索相关信息
-
多模态理解与对齐
- 模型审查搜索工具返回的混合视觉和文本信息
- 识别与查询最相关的部分,并将它们融合以支持后续推理过程
-
推理与回答
- 利用从搜索阶段检索到的相关视觉和文本线索
- 执行必要的推理步骤并给出最终答案,这也是一个结构化的、视觉丰富的报告
应用价值:
- 电商场景:通过图片搜索类似商品并比较价格
- 旅游规划:搜索景点图片并生成旅游攻略
- 学术研究:根据图表搜索相关论文并生成综述
3. 前端复制与视觉交互
GLM-4.6V 针对前端开发进行了优化,显著缩短了”设计到代码”的周期。
核心功能:
-
像素级复制
- 通过上传截图或设计文件,模型识别布局、组件和配色方案
- 生成高保真的 HTML/CSS/JS 代码
- 实现设计稿到可用代码的一键转换
-
交互式编辑
- 用户可以在生成的页面截图上圈出一个区域
- 给出自然语言指令(例如”将此按钮向左移动并使其变为深蓝色”)
- 模型自动定位并修改相应的代码片段
- 支持迭代式的视觉调整
实战场景:
- UI/UX 设计师快速将设计稿转换为代码原型
- 前端开发人员通过自然语言快速调整页面样式
- 产品经理通过截图描述需求,直接生成可用代码
4. 长上下文理解
GLM-4.6V 将其视觉编码器与 128K 上下文长度对齐,赋予模型巨大的记忆容量。在实践中,这相当于在单次推理中处理约 150 页复杂文档、200 个幻灯片页面或一小时长的视频。
相关资源
官方资源
更多文章