21
开源项目 HOT · 9 min read
腾讯开源 440MB 端侧翻译模型:1.25bit 量化,33 语言,质量超越 72B 大模型
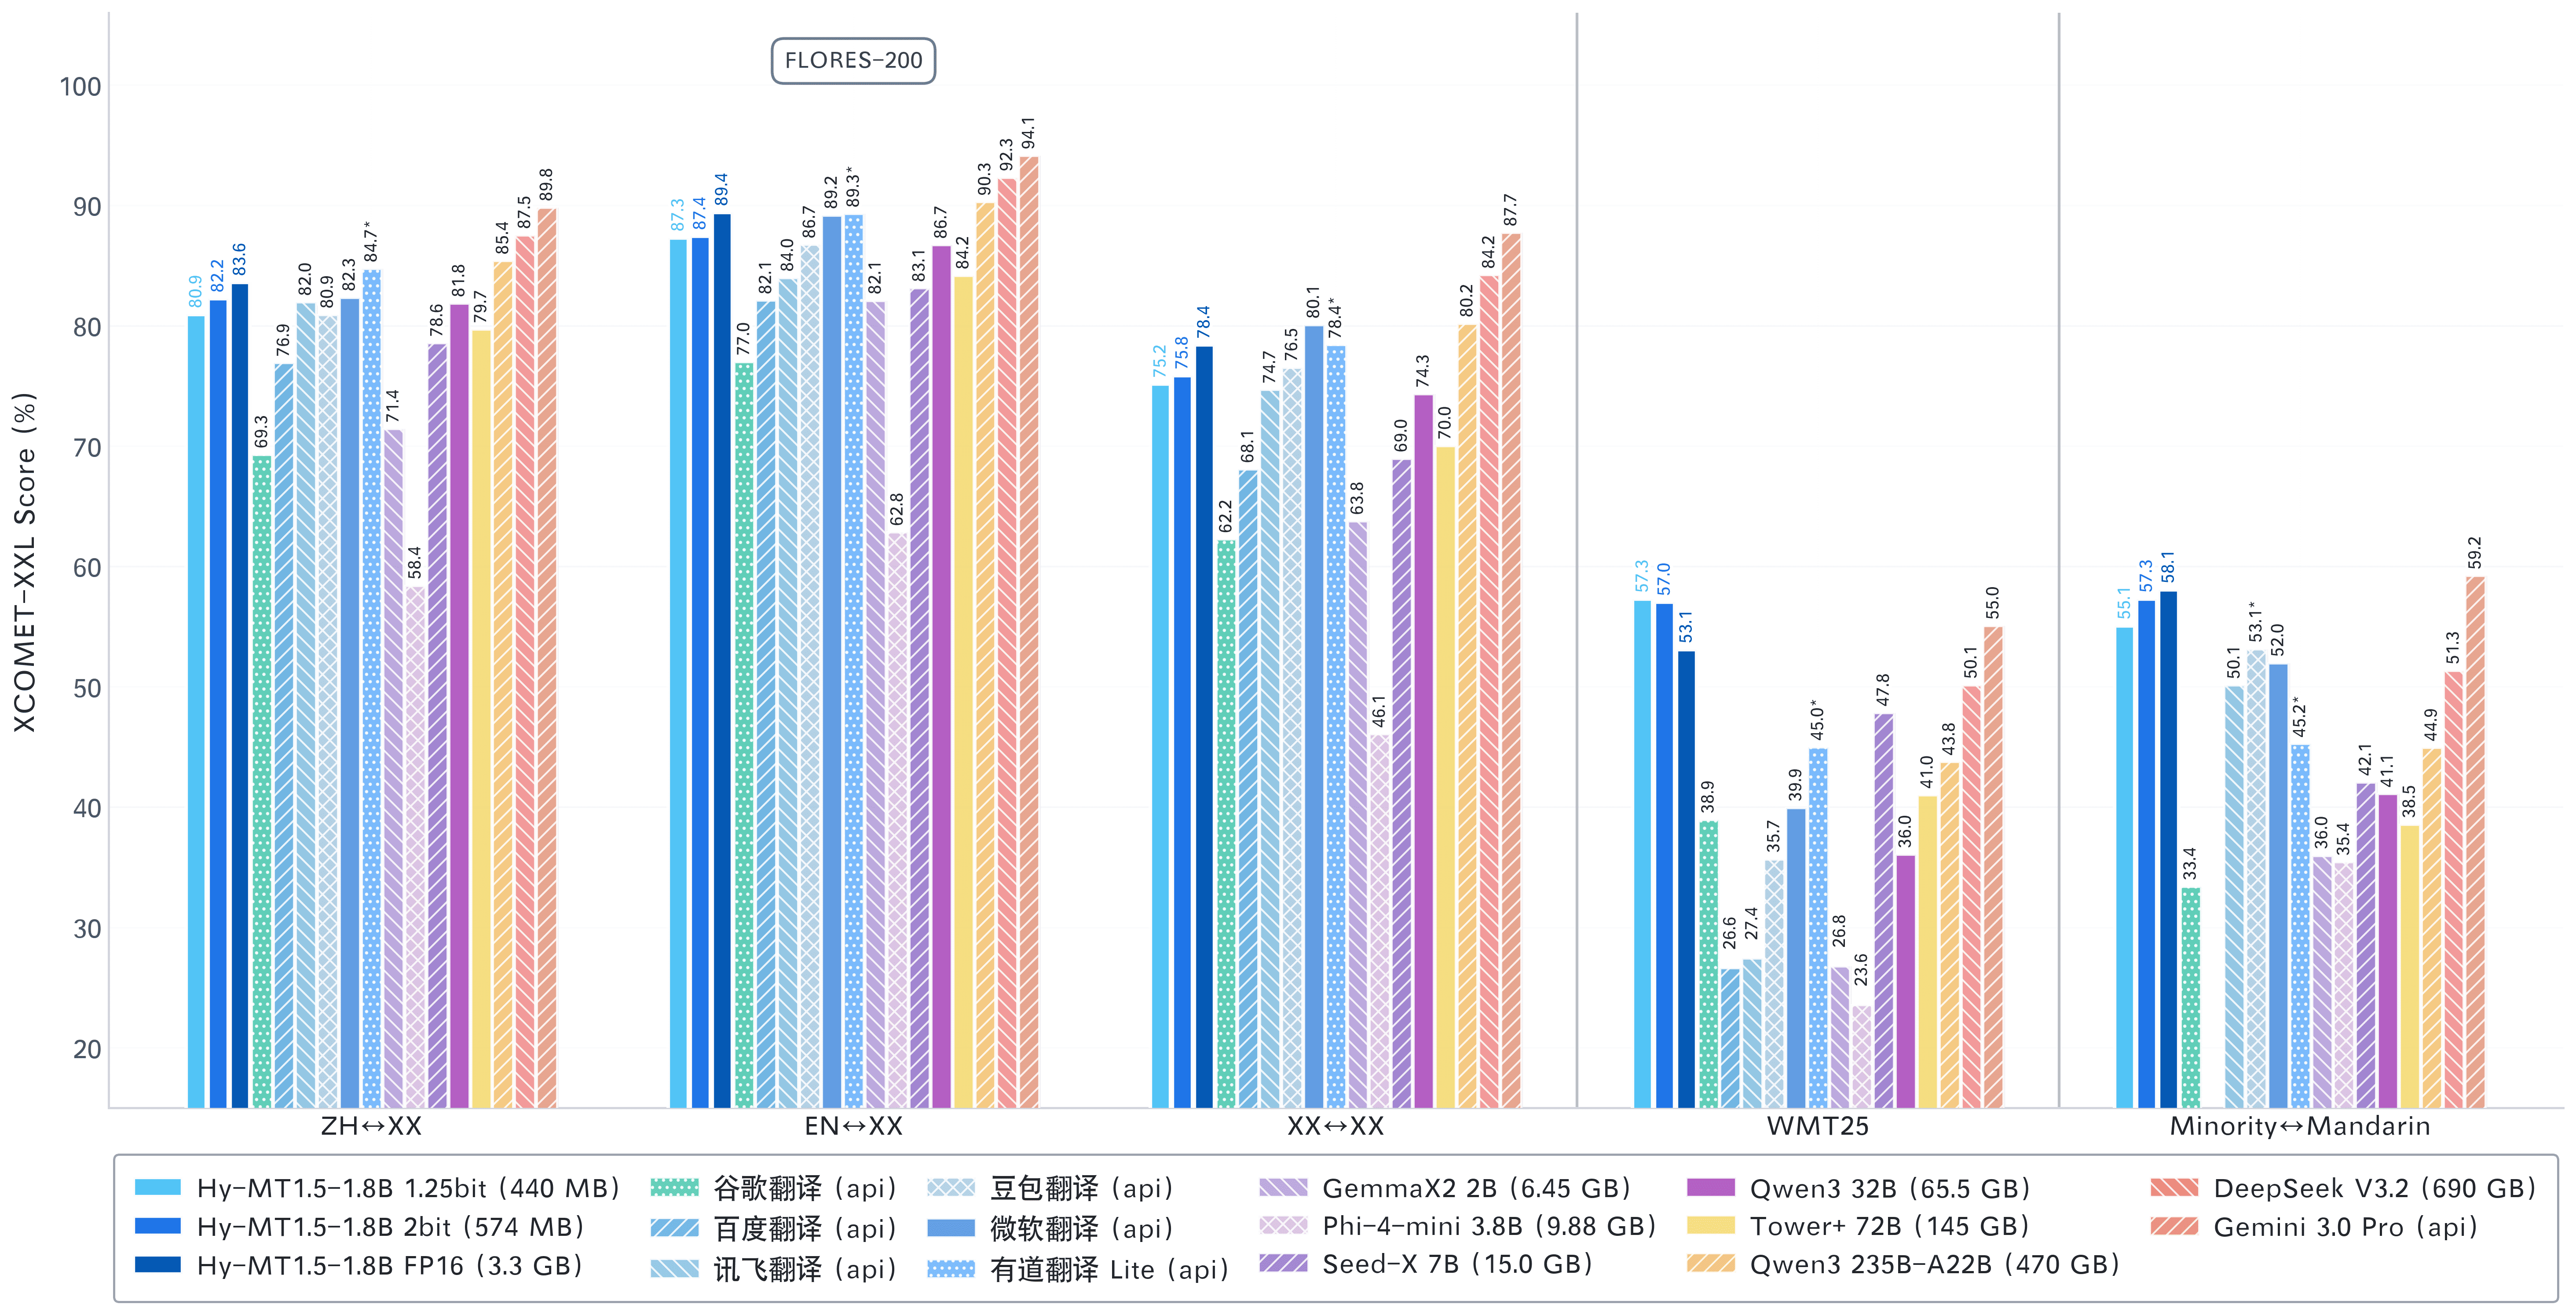
腾讯开源 Hy-MT1.5-1.8B-1.25bit 端侧翻译模型,仅 440MB 支持 33 种语言 1056 个翻译方向。采用 Sherry 1.25bit 量化技术,压缩率达 87%,翻译质量超越 72B 大模型
影响:开源社区
端侧模型 翻译模型

聚合全球 AI 模型、公司、开源项目和基础设施动态,帮助读者快速判断哪些更新值得继续关注。
腾讯开源 Hy-MT1.5-1.8B-1.25bit 端侧翻译模型,仅 440MB 支持 33 种语言 1056 个翻译方向。采用 Sherry 1.25bit 量化技术,压缩率达 87%,翻译质量超越 72B 大模型
DeepSeek-V4 正式发布!百万上下文标配,Agent 能力超越开源模型,推理性能比肩 GPT-4o 和 Claude Opus。Pro 版本达到顶级闭源模型水平,Flash 版本更快更经济。全新注意力机制 + DSA 稀疏注意力,计算和显存需求大幅降低

马斯克砸 600 亿美元收购 Cursor!SpaceX 与 AI 编程独角兽达成史上最贵收购期权协议,如不执行需支付 100 亿美元分手费。xAI 补齐代码短板,Cursor 获顶级算力支持,这场震撼交易背后的三大战略意图全解析

通义千问发布 Qwen3.6-35B-A3B,专注代码智能体和前端开发。新增思维保持功能,支持跨对话上下文。基于 Qwen3.5 架构,混合专家系统 + 稀疏激活,201 种语言支持,Apache 2.0 开源。

Anthropic 联合 AWS、Apple、Microsoft、Google 等 12 家科技巨头启动 Project Glasswing,投入 1 亿美元使用额度和 400 万美元捐赠。核心是 Claude Mythos Preview 模型,其漏洞发现能力超越人类,已发现数千个高危漏洞,包括 OpenBSD 27 年老漏洞、FFmpeg 16 年老漏洞等。

Google 发布 Gemma 4 多模态开放模型,密集+MoE 双架构,支持 25.6 万 token 长上下文,原生推理模式,从手机到服务器全场景覆盖。

Qwen3.5-Omni 是新一代原生全模态大模型,支持文本、图像、音频、视频输入输出。采用 Thinker-Talker 架构和 Hybrid-Attention MoE,支持 256k 上下文、10 小时音频、400 万帧视频处理,在 215 个基准测试中达到 SOTA。

OpenAI 宣布将关闭 Sora 视频生成 App,并将公布时间线与作品保全方案。本文梳理关键信息,并从算力分配、产品战略、版权与生态博弈角度聊聊我的看法。

OpenClaw技能市场遭遇供应链攻击:安全研究员8小时揭穿生态漏洞,1184个恶意技能被发现,13.5万实例暴露。深度解析AI Agent时代的npm投毒翻版,附开发者避坑指南。

Qwen3.5 MoE系列(0.8B-397B)采用Gated DeltaNet混合注意力。9B超越120B模型,0.8B可在手机处理视频。百万token上下文,原生多模态,支持201种语言。
