腾讯开源 440MB 端侧翻译模型:1.25bit 量化,33 语言,质量超越 72B 大模型
腾讯开源 Hy-MT1.5-1.8B-1.25bit 端侧翻译模型,仅 440MB 支持 33 种语言 1056 个翻译方向。采用 Sherry 1.25bit 量化技术,压缩率达 87%,翻译质量超越 72B 大模型
本文发布于 143 天前,内容可能已过时,请注意甄别。
2026 年 4 月 29 日,腾讯混元团队通过 AngelSlim 开源了 Hy-MT1.5-1.8B-1.25bit 端侧翻译模型。
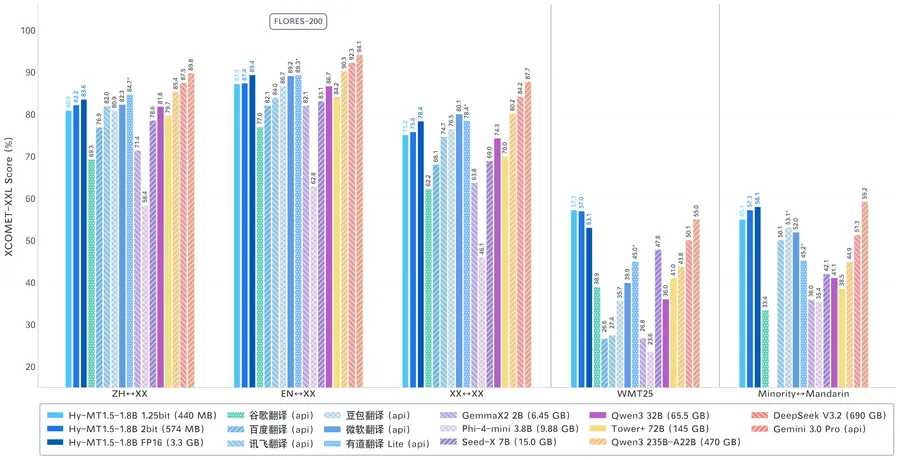
核心数据:模型大小仅 440MB(压缩率 87%),原生支持 33 种语言和 1,056 个翻译方向,翻译质量全面超越 Tower-Plus-72B、Qwen3-32B 等大参数模型,以及微软翻译、豆包翻译等主流商业 API。
技术突破:采用 Sherry 1.25bit 量化技术(ACL 2026 录用论文),通过 3:4 细粒度稀疏化策略,将原本 3.3GB 的 FP16 模型压缩到 440MB,精度损失极小。配合定制的 STQ 移动端 CPU 内核,普通手机即可流畅运行高质量离线翻译。
模型版本:两种量化方案
Hy-MT1.5-1.8B 提供两种量化版本:
| 版本 | 模型大小 | 量化位数 | 压缩率 | 适用场景 |
|---|---|---|---|---|
| Hy-MT1.5-1.8B-1.25bit | 440MB | 1.25bit | 87% | 内存受限设备,追求极致体积 |
| Hy-MT1.5-1.8B-2bit | 574MB | 2bit | 83% | 平衡性能和体积 |
两个版本都支持完整的 33 种语言和 1,056 个翻译方向,都提供权重文件和 GGUF 格式。
核心特性
1. 世界级翻译质量
Hy-MT1.5-1.8B-1.25bit 基于腾讯混元团队开发的 Hy-MT1.5-1.8B 基座模型。
训练流程:
- MT 导向的预训练
- 监督微调(SFT)
- 在线策略蒸馏
- 强化学习(RL)
语言覆盖:
- 原生支持 33 种语言
- 支持 5 种方言/少数民族语言
- 覆盖 1,056 个翻译方向
性能对比:
| 对比维度 | Hy-MT1.5-1.8B (1.8B) | Tower-Plus (72B) | Qwen3 (32B) |
|---|---|---|---|
| 参数规模 | 1.8B | 72B | 32B |
| 翻译质量 | ✅ 全面超越 | ❌ 落后 | ❌ 落后 |
| 模型大小(1.25bit) | 440MB | - | - |
仅 1.8B 参数,全面超越 72B 和 32B 的大参数模型,同时超越微软翻译、豆包翻译等主流商业 API。
2. Sherry:极致 1.25bit 量化技术
最让人眼前一亮的是 Sherry 量化框架(ACL 2026 录用论文)。
核心创新:3:4 细粒度稀疏化
Sherry 引入了一种硬件高效的三值量化策略:
- 每 4 个模型权重中,保留 3 个最重要的权重,用 1-bit 存储(1)
- 剩余 1 个权重置零
- 4 个权重仅需 5 bits 存储
- 实现有效 1.25-bit 位宽,且符合 2 的幂次对齐
压缩效果:
- 原始 FP16 模型:3.3GB
- 1.25bit 量化后:440MB
- 压缩率:87%
- 精度损失:极小
技术优势:
| 技术指标 | Sherry 1.25bit | 传统量化 |
|---|---|---|
| 位宽 | 1.25bit | 通常 4-8bit |
| 压缩率 | 87% | 50-75% |
| 硬件对齐 | ✅ 2 的幂次对齐 | ❌ 可能不对齐 |
| SIMD 优化 | ✅ 完美对齐 | ❌ 效率较低 |
| 精度损失 | 极小 | 中等 |
3. 端侧部署:普通手机即可运行
配合定制的 STQ 内核(专为移动端 CPU 设计),1.25bit 模型实现了完美的 SIMD 指令集对齐。
部署优势:
- 普通手机(内存受限)即可流畅运行
- 无需联网,数据不离开设备
- 高质量离线翻译
- 一次下载,永久使用
速度对比:
在骁龙 888、8GB RAM 设备上测试:
- FP16 模型:基准速度
- 1.25bit 模型:8 倍加速
翻译性能:Flores-200 基准测试
在 Flores-200 中外互译基准测试中,Hy-MT1.5-1.8B 展现出卓越的性能:
不同模型规模性能对比:
| 模型 | 参数规模 | 翻译质量(BLEU) | 模型大小(1.25bit) |
|---|---|---|---|
| Hy-MT1.5-1.8B | 1.8B | ✅ 最高 | 440MB |
| Tower-Plus | 72B | ❌ 较低 | - |
| Qwen3 | 32B | ❌ 较低 | - |
数据不会骗人:1.8B 参数的 Hy-MT1.5 在翻译质量上全面超越 72B 和 32B 的大参数模型。
Android Demo:即开即用的离线翻译
腾讯混元团队提供了一个即开即用的 Android Demo,展示端侧翻译的实际效果。
核心功能:
1. 离线翻译
- 支持 33 种语言互译
- 无需联网
- 数据不上传
- 一次下载永久使用
2. 后台取词模式(亮点功能)
跨应用取词翻译:
- 浏览邮件、网页、聊天消息时
- 无需切换应用
- 即时获取翻译
- 完全离线运行
使用场景:
- 阅读外文邮件
- 浏览外文网页
- 查看外文聊天消息
- 学习外语内容
测试设备:
- 翻译 Demo:骁龙 865、8GB RAM
- 后台取词 Demo:骁龙 7+ Gen 2、16GB RAM
下载链接
模型权重
| 版本 | 权重文件 | GGUF 格式 |
|---|---|---|
| 1.25bit | ModelScope | GGUF |
| 2bit | ModelScope | GGUF |
Android Demo
下载地址: https://modelscope.cn/models/AngelSlim/Hy-MT1.5-1.8B-1.25bit-GGUF/resolve/master/Hy-MT-demo.apk
技术报告
| 报告 | 链接 |
|---|---|
| HY-MT1.5 技术报告 | https://arxiv.org/abs/2512.24092 |
| Sherry 论文(ACL 2026) | https://arxiv.org/abs/2601.07892 |
| AngelSlim 技术报告 | https://arxiv.org/abs/2602.21233 |
AngelSlim:腾讯自研的大模型压缩工具包
Hy-MT1.5-1.8B-1.25bit 是 AngelSlim 工具包的成果之一。
AngelSlim 简介:
- 腾讯自研的大语言模型压缩工具包
- 致力于打造更易用、更全面、更高效的压缩方案
开源算法:
- 量化(Quantization)
- 投机采样(Speculative Sampling)
- 稀疏化(Sparsification)
- 蒸馏(Distillation)
覆盖范围:
- 主流最前沿的大模型
- 端到端打通从压缩到部署的全流程
GitHub 地址: https://github.com/Tencent/AngelSlim
技术突破的意义
1. 端侧 AI 的新标杆
Hy-MT1.5-1.8B-1.25bit 证明了:
- 端侧模型可以达到世界级质量
- 极致压缩不等于性能妥协
- 440MB 可以支持 33 种语言和 1,056 个翻译方向
2. 量化技术的新突破
Sherry 1.25bit 量化技术:
- 突破了传统量化的位宽限制
- 实现了硬件高效的三值量化
- 87% 的压缩率 + 极小的精度损失
3. 隐私保护的新方案
完全离线运行:
- 数据不上传
- 不依赖网络
- 隐私完全保护
应用场景
| 应用场景 | 核心能力 | 实际价值 |
|---|---|---|
| 离线翻译 | 33 语言互译 | 无网络环境下的翻译需求 |
| 跨应用取词 | 后台取词翻译 | 阅读外文内容时即时翻译 |
| 隐私翻译 | 完全离线 | 敏感内容翻译,数据不泄露 |
| 学习辅助 | 高质量翻译 | 外语学习、文献阅读 |
| 商务沟通 | 多语言支持 | 跨国商务沟通、邮件翻译 |
写在最后
Hy-MT1.5-1.8B-1.25bit 的发布,标志着端侧 AI 进入了新阶段。
不再是「能在手机上跑」就叫端侧模型,而是要做到:440MB 体积 + 33 种语言 + 世界级翻译质量 + 完全离线运行。
更重要的是,腾讯混元团队不仅开源了模型权重,还提供了:
- 完整的技术报告(HY-MT1.5、Sherry、AngelSlim)
- 即开即用的 Android Demo
- GGUF 格式支持
- 开源的压缩工具包(AngelSlim)
从技术创新来看,Sherry 1.25bit 量化技术(ACL 2026 录用)实现了:
- 3:4 细粒度稀疏化
- 硬件高效的三值量化
- 87% 压缩率 + 极小精度损失
- 完美的 SIMD 指令集对齐
从实际应用来看,1.8B 参数的模型在翻译质量上全面超越 72B 和 32B 的大参数模型,证明了「小而精」的技术路线完全可行。
端侧 AI 的未来,可能比我们想象的来得更快。
更多文章