320 题一个不拒,MMLU 却掉了 3.86 分:DeepSeek 无审查版的代价
Hugging Face 上出现 DeepSeek V4.1 Flash 无审查权重版:发布者称 HarmBench 320 题全部作答,但 MMLU 自测下降 3.86 个百分点,实测还需要 4 张 H200。
DeepSeek DeepSeek V4.1 开源模型
7 min read

7 篇文章
浏览关于 开源模型 的 7 篇文章、工具介绍与使用记录,按发布时间查找相关内容。
Hugging Face 上出现 DeepSeek V4.1 Flash 无审查权重版:发布者称 HarmBench 320 题全部作答,但 MMLU 自测下降 3.86 个百分点,实测还需要 4 张 H200。
Kimi K3 完整权重与 47 页技术报告正式公开。本文拆解 2.8T MoE、104B 激活参数、KDA、AttnRes、Stable LatentMoE、原生多模态、1M 上下文和 Agent 强化学习,并说明部署门槛与许可证限制。
Kimi K3 正式发布:2.8 万亿参数、原生多模态、100 万 token 上下文,API 输入 3 美元、输出 15 美元。本文对比 GPT-5.6 Sol 与 Claude Fable 5 的价格、能力和适用场景。
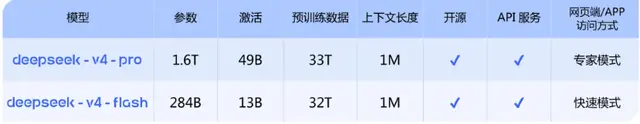
DeepSeek-V4 正式发布!百万上下文标配,Agent 能力超越开源模型,推理性能比肩 GPT-4o 和 Claude Opus。Pro 版本达到顶级闭源模型水平,Flash 版本更快更经济。全新注意力机制 + DSA 稀疏注意力,计算和显存需求大幅降低
通义千问发布 Qwen3.6-35B-A3B,专注代码智能体和前端开发。新增思维保持功能,支持跨对话上下文。基于 Qwen3.5 架构,混合专家系统 + 稀疏激活,201 种语言支持,Apache 2.0 开源。
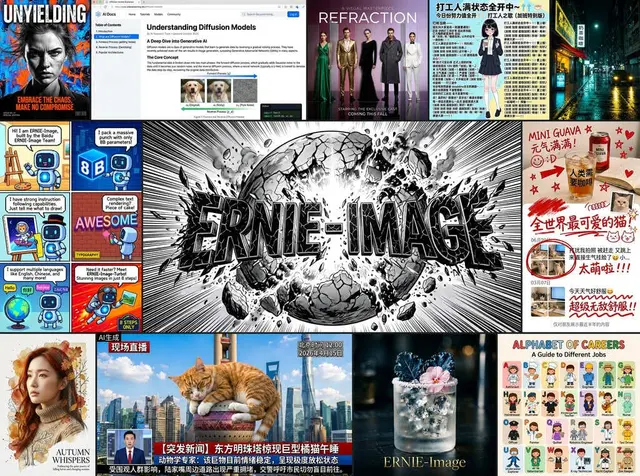
百度开源文生图模型 ERNIE-Image,仅 8B 参数达到开源 SOTA 性能。配备轻量级 Prompt Enhancer,在文本渲染、指令遵循、结构化生成等方面表现优异。GenEval 总分 0.8856,LongTextBench 中英文均超 0.96,24GB 显存即可运行。同步发布 Turbo 版本,8 步推理即可生成高质量图像。
Google 发布 Gemma 4 多模态开放模型,密集+MoE 双架构,支持 25.6 万 token 长上下文,原生推理模式,从手机到服务器全场景覆盖。