Kimi K3 发布:2.8 万亿参数、100 万上下文,价格只有 Claude Fable 5 三成
Kimi K3 正式发布:2.8 万亿参数、原生多模态、100 万 token 上下文,API 输入 3 美元、输出 15 美元。本文对比 GPT-5.6 Sol 与 Claude Fable 5 的价格、能力和适用场景。
本文发布于 54 天前,内容可能已过时,请注意甄别。
月之暗面正式发布 Kimi K3。这次最抢眼的不只是 2.8 万亿参数,而是它把原生多模态、100 万 token 上下文和前沿 Agent 能力,压到了 3 美元输入、15 美元输出的 API 价格。
但先把结论说清楚:Kimi 官方承认,K3 的整体表现仍落后于 GPT-5.6 Sol 和 Claude Fable 5。它真正有竞争力的地方,是用更低价格进入闭源顶尖模型附近的能力区间,并承诺开放完整权重。
30 秒速览
- 总参数量:2.8T,约 2.8 万亿参数
- 架构:MoE,每个 token 激活 896 个专家中的 16 个
- 上下文长度:100 万 token
- 模态:原生支持文本、图像与视频理解
- 核心方向:长周期编程、知识工作、深度推理与多模态 Agent
- API 价格:缓存命中输入 0.30 美元、未命中输入 3 美元、输出 15 美元 / 百万 token
- 开放计划:完整模型权重计划于 2026 年 7 月 27 日前发布
- 当前推理模式:默认使用 max,low 与 high 模式后续上线
Kimi K3 的参数有多夸张?
| 项目 | Kimi K3 |
|---|---|
| 总参数量 | 2.8T |
| 专家数量 | 896 |
| 每 token 激活专家 | 16 |
| 激活参数量 | 官方暂未公布 |
| 上下文窗口 | 1,048,576 token |
| 注意力架构 | Kimi Delta Attention(KDA) |
| 深度信息流 | Attention Residuals(AttnRes) |
| MoE 架构 | Stable LatentMoE |
| 量化训练 | MXFP4 权重、MXFP8 激活 |
2.8T 是总参数量,不代表每次推理都会调用全部参数。K3 采用高稀疏 MoE 架构,每个 token 只激活 16 个专家。官方没有公布准确的激活参数量,因此不能简单把 2.8T 当成实际推理规模。
Kimi 称,KDA、AttnRes 与 Stable LatentMoE 让 K3 相比 K2 获得约 2.5 倍整体扩展效率提升。简单说,它不是只把模型做大,也在解决长上下文速度、深层信息传递和超大规模 MoE 的训练稳定性。
价格对比:K3 最直接的优势
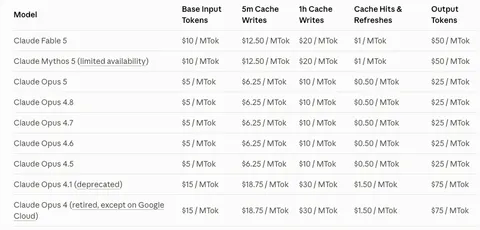
以下均为每 100 万 token 的标准 API 价格。GPT-5.6 Sol 采用短上下文价格;不同平台、长上下文和批处理价格可能不同。
| 模型 | 缓存输入 | 普通输入 | 输出 |
|---|---|---|---|
| Kimi K3 | $0.30 | $3 | $15 |
| GPT-5.6 Sol | $0.50 | $5 | $30 |
| Claude Fable 5 | $1 | $10 | $50 |
和 Claude Fable 5 相比,K3 的普通输入与输出价格都只有约 30%;和 GPT-5.6 Sol 相比,输入便宜 40%,输出便宜 50%。
按“100 万未缓存输入 + 20 万输出”粗算:
- Kimi K3:6 美元
- GPT-5.6 Sol:11 美元
- Claude Fable 5:20 美元
如果是代码仓库、文档库等重复上下文较多的任务,缓存价格更关键。Kimi 称其官方 API 在编程负载中的缓存命中率超过 90%,这会进一步降低长周期 Agent 的实际成本。
和顶尖模型比,K3 到底处于什么位置?
Kimi 对 K3 的定位很克制:达到前沿水平,但整体仍落后于最强闭源模型。
| 模型 | 核心优势 | 主要取舍 |
|---|---|---|
| Kimi K3 | 价格低、100 万上下文、原生多模态、计划开放权重 | 整体体验仍落后于 GPT-5.6 Sol 和 Claude Fable 5,部署门槛高 |
| GPT-5.6 Sol | 综合推理、编程与 Agent 能力处于第一梯队 | 闭源,API 成本高于 K3 |
| Claude Fable 5 | 长周期 Agent、复杂知识工作与代码任务强 | 三者中 API 价格最高,闭源 |
Kimi 公布的测试显示,K3 在长周期编程、GPU Kernel 优化、知识工作和多模态创作上已具备很强竞争力。不过这些结果来自厂商评测,且不同模型使用的 Agent harness 并不完全一致,不能直接理解为 K3 已全面超过 GPT 或 Claude。
K3 真正值得关注的三个特点
1. 100 万上下文不是摆设
K3 的目标不是单轮聊天,而是大型代码库、长文档、持续研究和多工具 Agent。官方在 BrowseComp 测试中提到,K3 可直接使用 100 万上下文,不依赖频繁压缩历史记录。
2. 原生多模态进入编程闭环
K3 可以把代码、截图、图像和视频放进同一个工作流。它能根据运行截图继续修改前端、游戏和 CAD 项目,也能处理视频剪辑与动态图形任务。
3. 开放权重比参数规模更重要
2.8T 很吸睛,但完整权重开放才决定 K3 是否会影响开源生态。Kimi 表示权重将在 7 月 27 日前发布,不过官方也建议使用 64 张以上加速卡组成的超节点部署,这意味着普通团队很难低成本自托管完整模型。
现在还要注意这些限制
- 发布初期只有 max 推理强度,低成本模式还未上线
- 完整权重和技术报告尚未发布
- 对完整思考历史较敏感,中途从其他模型切换到 K3 可能导致质量波动
- 在意图模糊时可能过度主动,需要更严格的系统提示词或
AGENTS.md约束 - 官方明确承认,整体用户体验与 GPT-5.6 Sol、Claude Fable 5 仍有差距
结论
Kimi K3 不是“参数最大,所以能力最强”。它更准确的定位是:目前最激进的开放前沿模型之一,用闭源旗舰三到六成的 API 价格,提供接近第一梯队的长上下文、多模态和 Agent 能力。
对开发者来说,短期最值得看的不是 2.8T,而是两件事:实际 API 任务成本,以及 7 月 27 日权重发布后,开源推理框架能否真正接住这台超大模型。
参考来源:
更多文章