SAM-Audio Technical Analysis: Cross-Modal Breakthrough from Computer Vision to Audio Separation
In-depth analysis of Meta's SAM-Audio model vs computer vision SAM. Explore multimodal prompting, audio separation techniques, and practical applications in this cross-modal AI breakthrough.
Published 285 days ago. Content may be outdated.
Preface
Following Meta’s revolutionary Segment Anything Model (SAM) in computer vision, the Facebook Research team has struck again, extending the “segment anything” concept to the audio domain with SAM-Audio. This innovation migrates successful visual segmentation experience to audio processing, achieving the goal of “isolating any sound” and bringing a new foundational model paradigm to the audio processing field.
Project Overview
Core Capabilities
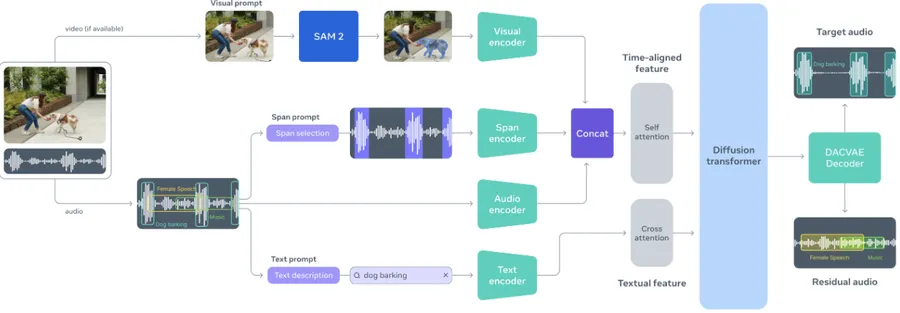
SAM-Audio is an audio foundation model that can separate specific sounds from complex audio mixtures using text, visual, or temporal prompts. Its core characteristics include:
- Multimodal Prompting Support: Supports three types of prompts - natural language descriptions, visual cues, and time spans
- High-Precision Audio Separation: Can accurately extract target sounds from complex audio environments
- Flexible Application Scenarios: Suitable for speech separation, music production, sound effect processing, and other fields
Technical Architecture
SAM-Audio adopts a similar architectural design approach to visual SAM, but with specialized optimizations for audio data characteristics:
       from sam_audio import SAMAudio, SAMAudioProcessor
import torchaudio

# Model loading and initialization
model = SAMAudio.from_pretrained("facebook/sam-audio-large")
processor = SAMAudioProcessor.from_pretrained("facebook/sam-audio-large")
model = model.eval().cuda()

# Basic audio separation workflow
def audio_separation_demo(audio_file, description):
    """
    Demonstrate basic audio separation functionality

    Args:
        audio_file: Audio file path
        description: Text description of target sound
    """
    # Data preprocessing
    batch = processor(
        audios=[audio_file],
        descriptions=[description],
    ).to("cuda")

    # Execute separation
    result = model.separate(batch)

    # Save results
    sample_rate = processor.audio_sampling_rate
    torchaudio.save("target.wav", result.target.cpu(), sample_rate)      # Target sound
    torchaudio.save("residual.wav", result.residual.cpu(), sample_rate)  # Other sounds

    return result
Comparative Analysis with Computer Vision SAM
Core Concept Comparison
| Feature | CV SAM | SAM-Audio |
|---|---|---|
| Target Task | Object segmentation in images | Sound separation in audio |
| Input Modality | Image data | Audio data |
| Prompting Methods | Click, box selection, text | Text, visual, time span |
| Output Results | Segmentation masks | Separated audio streams |
| Application Domains | Computer vision, image editing | Audio processing, speech separation |
Technical Implementation Comparison
1. Data Representation Differences
CV SAM:
- Processes 2D image data (H × W × C)
- Strong spatial correlation with clear adjacency relationships between pixels
SAM-Audio:
- Processes 1D temporal audio data
- Strong temporal correlation with important frequency domain features
- Needs to consider spectral features and temporal dynamics
2. Prompting Mechanism Innovation
Text Prompting Comparison:
       # CV SAM text prompt (conceptual example)
cv_prompt = "a cat"  # For guiding visual segmentation

# SAM-Audio text prompt
audio_prompt = "a man speaking"  # For guiding audio separation
processor(audios=[audio], descriptions=[audio_prompt])
SAM-Audio’s Unique Multimodal Prompts:
       # 1. Visual prompting: Using video frames and masks
processor(
    audios=[video],
    descriptions=[""],
    masked_videos=processor.mask_videos([frames], [mask])
)

# 2. Time span prompting: Specifying time ranges where target sound occurs
processor(
    audios=[audio],
    descriptions=["car horn"],
    anchors=[[["+", 6.3, 7.0]]]  # Between 6.3 and 7.0 seconds
)
3. Architectural Design Correspondence
| Component | CV SAM | SAM-Audio |
|---|---|---|
| Encoder | Vision Transformer | Audio encoder (possibly Transformer-based) |
| Prompt Encoder | Point/box/text encoder | Text/visual/temporal encoder |
| Decoder | Mask decoder | Audio separation decoder |
| Output | Segmentation masks | Target audio + residual audio |
In-Depth Technical Analysis
1. Multi-Scale Model Support
SAM-Audio provides three different model scales to meet various performance requirements:
       # Model scale comparison
models = {
    "small": "facebook/sam-audio-small",    # Lightweight, suitable for resource-constrained environments
    "base": "facebook/sam-audio-base",      # Balanced performance and efficiency
    "large": "facebook/sam-audio-large"     # Best performance, requires more computational resources
}

# Specially optimized visual prompting versions
visual_optimized_models = {
    "small-tv": "facebook/sam-audio-small-tv",
    "base-tv": "facebook/sam-audio-base-tv",
    "large-tv": "facebook/sam-audio-large-tv"
}
2. Performance Evaluation Metrics
According to official evaluation, subjective scores of each model on different audio types (out of 5 points):
| Model | General SFX | Speech | Speaker | Music | Instrument (Wild) | Instrument (Pro) |
|---|---|---|---|---|---|---|
| small | 3.62 | 3.99 | 3.12 | 4.11 | 3.56 | 4.24 |
| base | 3.28 | 4.25 | 3.57 | 3.87 | 3.66 | 4.27 |
| large | 3.50 | 4.03 | 3.60 | 4.22 | 3.66 | 4.49 |
3. Practical Application Examples
       class AudioSeparationPipeline:
    """Complete audio separation processing pipeline"""

    def __init__(self, model_name="facebook/sam-audio-large"):
        """Initialize audio separation pipeline"""
        self.model = SAMAudio.from_pretrained(model_name)
        self.processor = SAMAudioProcessor.from_pretrained(model_name)
        self.model = self.model.eval().cuda()

    def separate_speech(self, audio_file, speaker_description="male voice"):
        """Speech separation: Extract specific speaker from multi-person conversation"""
        batch = self.processor(
            audios=[audio_file],
            descriptions=[speaker_description],
        ).to("cuda")

        result = self.model.separate(batch)
        return result

    def separate_music_instrument(self, audio_file, instrument="piano"):
        """Music separation: Extract specific instrument from band performance"""
        batch = self.processor(
            audios=[audio_file],
            descriptions=[f"{instrument} playing"],
        ).to("cuda")

        result = self.model.separate(batch)
        return result

    def time_based_separation(self, audio_file, description, start_time, end_time):
        """Time-based audio separation"""
        batch = self.processor(
            audios=[audio_file],
            descriptions=[description],
            anchors=[[["+", start_time, end_time]]]
        ).to("cuda")

        result = self.model.separate(batch)
        return result

# Usage examples
pipeline = AudioSeparationPipeline()

# Speech separation
speech_result = pipeline.separate_speech("meeting_recording.wav", "female speaker")

# Music separation
music_result = pipeline.separate_music_instrument("orchestra.wav", "violin")

# Time segment separation
time_result = pipeline.time_based_separation("street_noise.wav", "car sound", 5.0, 10.0)
Conclusion
The launch of SAM-Audio marks the beginning of a new era in audio processing. By migrating the successful “segment anything” concept from computer vision to the audio domain, Meta has once again demonstrated its technical prowess in AI foundation models. This innovation not only provides powerful tools for audio processing but also opens new possibilities for cross-modal AI technology development.
From a technical perspective, SAM-Audio maintains high consistency with CV SAM in architectural design and core concepts while incorporating specialized optimizations for audio data characteristics. This design approach provides valuable experience for future development of “Segment Anything” models in other modalities.
As technology continues to improve and application scenarios expand, SAM-Audio is expected to become important infrastructure in the audio processing field, driving the development and innovation of related industries. For developers and researchers, the open-source release of this tool will undoubtedly accelerate the popularization and application of audio AI technology.
This article is based on SAM-Audio official documentation and technical materials, aimed at providing comprehensive technical analysis and application guidance for readers.
More Articles