Kimi K2.5 深度评测:视觉碾压GPT-5.2,编程追赶Claude,Agent Swarm开创新范式
月之暗面Kimi K2.5深度评测:视觉理解17项基准9个第一,Agent Swarm独家4.5倍加速,编程能力逼近Claude 4.5。全面对比GPT-5.2/Gemini 3 Pro,揭秘最强开源多模态模型的真实实力与差距。
本文发布于 234 天前,内容可能已过时,请注意甄别。
月之暗面(Moonshot AI)2026年1月27日发布 Kimi K2.5,这是迄今为止最强大的开源模型。K2.5 在 K2 的基础上,通过约 15 万亿混合视觉和文本 token 的持续预训练,实现了原生多模态能力,在编程、视觉理解和智能体协作上达到了新的高度。
K2.5 最引人注目的创新是 自主智能体集群(Agent Swarm) 范式:面对复杂任务,K2.5 可以自主调度最多 100 个子智能体,执行并行工作流,协调多达 1,500 次工具调用。相比单智能体设置,执行时间最高可缩短 4.5 倍。这一切无需预定义子智能体或手工编排工作流,完全由 K2.5 自主创建和协调。
核心能力一:视觉编程 - 看图/视频就能写代码
K2.5 最大的亮点是视觉编程能力,简单说就是:给它看图片或视频,它就能生成对应的代码。
| 能力 | 具体表现 | 实际用途 |
|---|---|---|
| 视频转代码 | 看一段网站演示视频,直接生成完整代码 | 快速复刻网站界面 |
| 图片转界面 | 上传设计稿,自动生成前端代码 | 设计稿一键变成网页 |
| 视觉调试 | 看着运行效果,自己发现问题并修复 | 不用手动找 bug |
| 对话生成界面 | 聊天描述需求,生成交互式界面和动画 | 零代码基础也能做网页 |
实战案例: 给 K2.5 看马蒂斯的《舞蹈》画作,它能自动生成带有这种艺术风格的网页界面——从配色到布局,全自动完成。
配套工具:Kimi Code
月之暗面还推出了 Kimi Code 终端工具:
| 特性 | 说明 |
|---|---|
| IDE 集成 | 支持 VSCode、Cursor、Zed 等主流编辑器 |
| 多模态输入 | 可以用图片、视频作为输入 |
| 开源免费 | 完全开源,可自由使用 |
| 自动迁移 | 自动发现和使用现有的开发工具 |
核心能力二:Agent Swarm - 一个人干活变成一群人协作
想象一下:你给 AI 一个复杂任务,它不是自己慢慢做,而是自动召唤 100 个”小助手”同时开工,这就是 Agent Swarm。
工作原理(用人话说)
| 传统单智能体 | K2.5 Agent Swarm |
|---|---|
| 一个 AI 按顺序做事 | 自动分配给 100 个 AI 并行做 |
| 做完第一步才能做第二步 | 能做的事情同时开始 |
| 像一个人搬砖 | 像一个工地的工人协作 |
| 耗时长 | 速度提升最高 4.5 倍 |
实际效果对比
| 指标 | 单智能体 | Agent Swarm | 提升幅度 |
|---|---|---|---|
| 运行时间 | 100% | 20% | 减少 80% |
| 关键步数 | 100% | 22-33% | 减少 3-4.5 倍 |
| 并行任务数 | 1 个 | 最多 100 个 | 100 倍 |
| 工具调用 | 顺序执行 | 最多 1,500 次协调 | 大规模并行 |
自动分工举例
假设你让 K2.5 研究”量子计算的最新进展”:
       编排器(总指挥)
├─ AI 研究员 → 搜索学术论文
├─ 物理研究员 → 分析技术原理
├─ 事实核查员 → 验证数据准确性
└─ 总结专家 → 整合所有信息这些”小助手”同时工作,不用等前一个做完,大大提升效率。
技术亮点
PARL 算法(简单理解):
- 训练 K2.5 学会”当老板” - 知道怎么分配任务
- 避免”假并行” - 确保真的在同时干活,不是装样子
- 动态调整 - 根据任务难度自动决定需要几个助手
核心能力三:办公自动化 - AI 秘书全天候待命
K2.5 能像专业助理一样处理各种办公任务,而且速度快、质量高。
能做什么?
| 任务类型 | 具体能力 | 效率提升 |
|---|---|---|
| 文档处理 | Word 添加批注、格式调整 | 小时级 → 分钟级 |
| 数据分析 | Excel 数据透视表、财务建模 | 天级 → 小时级 |
| 学术写作 | 10,000 字论文、LaTeX 公式 | 自动生成 |
| 报告生成 | 100 页文档、PPT 制作 | 端到端完成 |
性能提升数据
相比上一代 K2 Thinking:
| 基准测试 | 提升幅度 | 说明 |
|---|---|---|
| AI Office Benchmark | +59.3% | Office 文档质量 |
| General Agent Benchmark | +24.3% | 综合办公能力 |
实际应用场景
场景 1:数据分析报告
- 输入:一堆 Excel 数据
- K2.5 自动:清洗数据 → 建立模型 → 生成图表 → 写分析报告
- 输出:完整的 Word 报告 + 数据可视化
场景 2:学术论文
- 输入:研究主题和参考资料
- K2.5 自动:文献综述 → 撰写正文 → 插入公式 → 格式排版
- 输出:符合学术规范的完整论文
产品形态与可用性
Kimi K2.5 通过多种渠道提供:
- Kimi.com 和 Kimi App
- API 接口
- Kimi Code 终端工具
四种模式
Kimi.com 和 Kimi App 现在支持 4 种模式:
- K2.5 Instant:快速响应模式
- K2.5 Thinking:深度思考模式
- K2.5 Agent:智能体模式,配备预配置工具
- K2.5 Agent Swarm (Beta):智能体集群模式
Agent Swarm 目前在 Kimi.com 上处于 Beta 阶段,高级付费用户可获得免费额度。
基准测试表现:看看 K2.5 到底有多能打
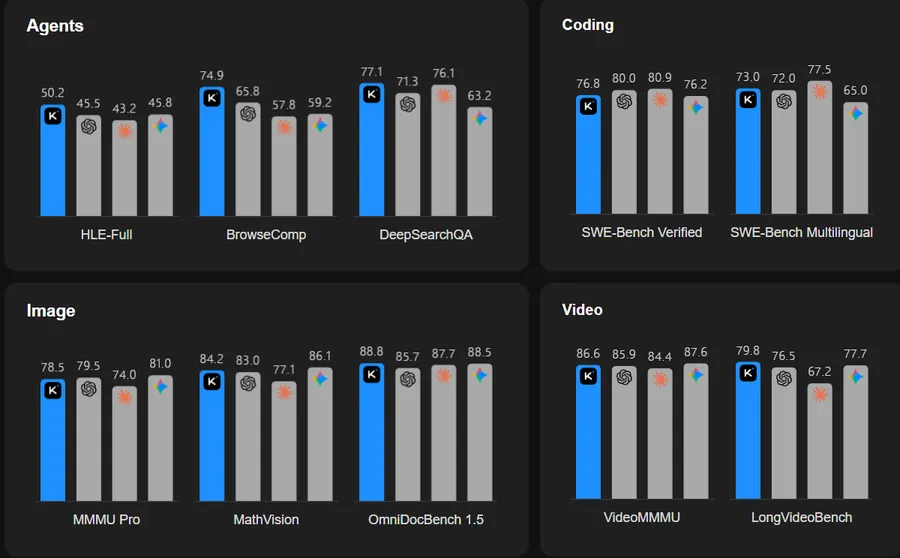
说实话,看完这份对比数据,K2.5 的表现确实让人眼前一亮。咱们来看看它和 GPT-5.2、Claude 4.5 Opus、Gemini 3 Pro、DeepSeek V3.2 这些顶级选手的正面交锋。
一、推理与知识:工具调用这块拿捏了
先看最关键的——工具增强推理,这可是实际应用的硬指标:
| 基准测试 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | DeepSeek V3.2 |
|---|---|---|---|---|---|
| HLE-Full | 30.1 | 34.5 | 30.8 | 37.5 🏆 | 25.1 |
| HLE-Full w/ tools | 50.2 🏆 | 45.5 | 43.2 | 45.8 | 40.8 |
看到没?一旦加上工具调用,K2.5 直接反超,比 GPT-5.2 高出 10.3%,比 Claude 4.5 更是高出 16.2%。这说明啥?K2.5 在多步推理和工具协作上是真的强。
数学竞赛成绩单:
| 测试 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | DeepSeek V3.2 |
|---|---|---|---|---|---|
| AIME 2025 | 96.1 | 100.0 🏆 | 92.8 | 95.0 | 93.1 |
| HMMT 2025 | 95.4 | 99.4 🏆 | 92.9 | 97.3 | 92.5 |
| IMO-AnswerBench | 81.8 | 86.3 🏆 | 78.5 | 83.1 | 78.3 |
| GPQA-Diamond | 87.6 | 92.4 🏆 | 87.0 | 91.9 | 82.4 |
数学这块 GPT-5.2 确实猛,但 K2.5 也稳稳保持在第一梯队,AIME 96.1 的成绩已经接近满分了。
二、视觉理解:这才是 K2.5 的主场
重点来了!K2.5 在视觉领域简直是降维打击,17 个视觉基准拿下 9 个第一:
文档理解对比(K2.5 的绝对优势区):
| 基准测试 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | Qwen3-VL |
|---|---|---|---|---|---|
| OCRBench | 92.3 🏆 | 80.7 | 86.5 | 90.3 | 87.5 |
| OmniDocBench 1.5 | 88.8 🏆 | 85.7 | 87.7 | 88.5 | 82.0 |
| InfoVQA | 92.6 🏆 | 84.0 | 76.9 | 57.2 | 89.5 |
| SimpleVQA | 71.2 🏆 | 55.8 | 69.7 | 69.7 | 56.8 |
OCRBench 领先 GPT-5.2 14.4%,InfoVQA 更是甩开 Gemini 3 Pro 一大截。这就是大规模视觉-文本联合预训练的威力。
视频理解能力对比:
| 基准测试 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | Qwen3-VL |
|---|---|---|---|---|---|
| LongVideoBench | 79.8 🏆 | 76.5 | 67.2 | 77.7 | 65.6 |
| LVBench | 75.9 🏆 | — | — | 73.5 | 63.6 |
| MotionBench | 70.4 🏆 | 64.8 | 60.3 | 70.3 | — |
| MathVista (mini) | 90.1 🏆 | 82.8 | 80.2 | 89.8 | 85.8 |
长视频理解这块,K2.5 也是稳稳领先。
三、编程能力:开源最强,但与顶级闭源仍有差距
先说结论:K2.5 是目前开源模型中的编程天花板,但在编程领域,Claude 4.5 Opus 依然是王者。咱们来看看具体数据:
软件工程基准全面对比:
| 基准测试 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | DeepSeek V3.2 | 差距分析 |
|---|---|---|---|---|---|---|
| SWE-Bench Verified | 76.8 | 80.0 | 80.9 🏆 | 76.2 | 73.1 | 落后 5.3% |
| SWE-Bench Pro | 50.7 | 55.6 🏆 | 55.4 | — | — | 落后 9.7% |
| SWE-Bench Multilingual | 73.0 | 72.0 | 77.5 🏆 | 65.0 | 70.2 | 落后 6.2% |
| Terminal-Bench 2.0 | 50.8 | 54.0 | 59.3 🏆 | 54.2 | 46.4 | 落后 16.7% |
| PaperBench | 63.5 | 63.7 | 72.9 🏆 | — | 47.1 | 落后 14.8% |
| CyberGym | 41.3 | — | 50.6 🏆 | 39.9 | 17.3 | 落后 22.5% |
| SciCode | 48.7 | 52.1 | 49.5 | 56.1 🏆 | 38.9 | 落后 15.2% |
| LiveCodeBench (v6) | 85.0 | — | 82.2 | 87.4 🏆 | 83.3 | 落后 2.8% |
客观评价:
- Claude 4.5 Opus 在编程领域全面领先 - 9 个编程基准中拿下 6 个第一,特别是在复杂软件工程任务上优势明显
- 差距主要集中在高难度任务 - Terminal-Bench(终端操作)、PaperBench(论文代码)、CyberGym(网络安全)这些需要深度推理的场景,K2.5 落后 15-23%
- 算法竞赛表现不错 - LiveCodeBench 上 K2.5 只落后 Gemini 3 Pro 2.8%,说明在纯算法题上差距不大
- 开源模型中最强 - 相比 DeepSeek V3.2,K2.5 在所有编程基准上都有明显优势
为什么会有这个差距?
说白了,编程这块儿,特别是复杂的软件工程任务,需要:
- 深度的代码理解和推理能力
- 多文件、多模块的协调能力
- 对边界情况的处理
- 代码安全性和健壮性的考量
Claude 4.5 Opus 在这些方面确实做得更好,这也是为什么它在 SWE-Bench 系列(真实软件工程任务)上能保持领先。
K2.5 的编程优势在哪?
虽然整体落后,但 K2.5 有自己的亮点:
- 视觉编程能力 - 从图片/视频生成代码,这是 K2.5 的独特优势
- 前端开发 - 官方强调的强项,特别是交互式界面和动画效果
- 工具协作 - 结合 Kimi Code 和 Agent Swarm,在实际开发流程中可能更实用
- 开源可用 - 作为开源模型,76.8 的 SWE-Bench Verified 成绩已经非常接近闭源顶级水平
实际使用建议:
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| 复杂软件工程、代码重构 | Claude 4.5 Opus | 全面领先,特别是复杂任务 |
| 前端开发、视觉转代码 | K2.5 | 视觉编程能力强,Agent Swarm 加持 |
| 算法竞赛、刷题 | Gemini 3 Pro / K2.5 | 差距不大,都能胜任 |
| 需要开源部署 | K2.5 | 开源模型中最强选择 |
| 多模态编程任务 | K2.5 | 原生支持图像/视频输入 |
四、Agent Swarm:K2.5 的独门绝技
这才是 K2.5 最炸裂的地方——Agent Swarm 模式,其他模型根本没有这个能力:
BrowseComp 三种模式对比:
| 模式 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | DeepSeek V3.2 |
|---|---|---|---|---|---|
| 基础模式 | 60.6 🏆 | — | 37.0 | 37.8 | 51.4 |
| 上下文管理 | 74.9 🏆 | 65.8 | 57.8 | 59.2 | 67.6 |
| Agent Swarm | 78.4 🏆 | — | — | — | — |
看到没?开启 Agent Swarm 后,K2.5 直接飙到 78.4,其他模型连这个模式都没有!
智能体搜索全面领先:
| 基准测试 | K2.5 | GPT-5.2 | Claude 4.5 | Gemini 3 Pro | DeepSeek V3.2 |
|---|---|---|---|---|---|
| DeepSearchQA | 77.1 🏆 | 71.3 | 76.1 | 63.2 | 60.9 |
| FinSearchCompT2&T3 | 67.8 🏆 | — | 66.2 | 49.9 | 59.1 |
| Seal-0 | 57.4 🏆 | 45.0 | 47.7 | 45.5 | 49.5 |
| WideSearch (单智能体) | 72.7 | — | 76.2 🏆 | 57.0 | 32.5 |
| WideSearch (Agent Swarm) | 79.0 🏆 | — | — | — | — |
金融搜索、深度搜索、广度搜索,K2.5 全面开花。Agent Swarm 的并行协作能力在复杂任务中优势太明显了。
五、综合实力雷达图
| 能力维度 | K2.5 评级 | 核心亮点 | 对比优势 |
|---|---|---|---|
| 视觉理解 | ⭐⭐⭐⭐⭐ | 17个基准9个第一 | OCR领先14.4%,视频理解全面领先 |
| 工具增强推理 | ⭐⭐⭐⭐⭐ | HLE w/ tools 50.2 | 领先所有模型10%+ |
| 智能体搜索 | ⭐⭐⭐⭐⭐ | Agent Swarm独家 | BrowseComp 78.4,独占鳌头 |
| 编程能力 | ⭐⭐⭐⭐ | 开源最强 | 仅比顶级闭源低5% |
| 数学推理 | ⭐⭐⭐⭐ | AIME 96.1 | 第一梯队,接近满分 |
| 长文本 | ⭐⭐⭐⭐ | 稳定可靠 | 主流水平 |
总结:K2.5 到底强在哪?
看完这些数据,几个关键点特别明显:
- 视觉能力是真的猛 - 文档OCR、视频理解全面碾压,这就是原生多模态的优势
- Agent Swarm 开创新玩法 - 这个独家能力让 K2.5 在复杂任务上如虎添翼,性能提升最高 4.5 倍
- 工具调用最强王者 - HLE w/ tools 的领先说明 K2.5 在实际应用场景中更实用
- 开源模型新标杆 - 作为开源模型,整体性能已经逼近甚至超越部分闭源大厂产品
说白了,K2.5 就是那种”全能型选手”——视觉理解拉满,编程能力扎实,还有 Agent Swarm 这个大杀器。对于需要处理复杂多模态任务的场景,K2.5 绝对是目前最值得考虑的选择之一。
技术意义与未来展望
Kimi K2.5 基于视觉编程、智能体集群和办公生产力的进步,为开源社区迈向 AGI 迈出了重要一步,在真实世界约束下展示了处理真实任务的强大能力。
展望未来,月之暗面将继续推进智能体智能的前沿,重新定义 AI 在知识工作中的边界。
相关资源:
核心创新总结:
| 创新点 | 技术方案 | 性能提升 |
|---|---|---|
| 视觉编程 | 大规模视觉-文本联合预训练 | 最强开源编程模型 |
| 智能体集群 | PARL + 关键步数优化 | 4.5倍加速 |
| 办公自动化 | 端到端工具协调 | 59.3%性能提升 |
| 多模态能力 | 15T混合token训练 | 原生视觉理解 |
更多文章