
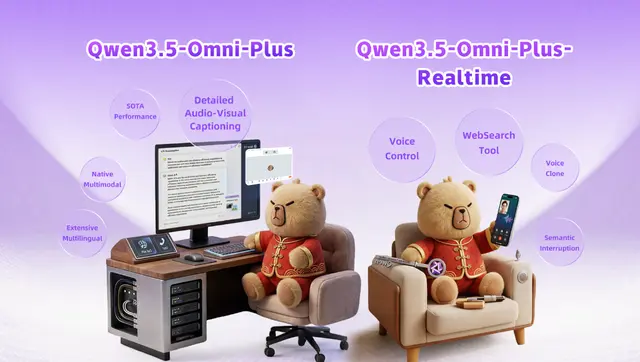
Qwen3.5-Omni: 10-Hour Audio, 4M Frame Video, SOTA in 215 Benchmarks
Qwen3.5-Omni: Native multimodal model with 256k context, 10-hour audio, 4M frame video support. Thinker-Talker + Hybrid-Attention MoE architecture achieves SOTA in 215 benchmarks.
Qwen3.5-Omni Multimodal AI AI models
5 min read