隆重推出 GPT-5.2:为专业工作与长时运行智能体打造的前沿模型
OpenAI 发布 GPT-5.2 模型系列,面向专业知识型工作与长时运行智能体,在长上下文、工具调用、视觉与软件工程等方面实现显著提升,并公布多项基准新纪录与定价信息。
本文发布于 281 天前,内容可能已过时,请注意甄别。
2025 年 12 月 11 日,OpenAI 发布了 GPT‑5.2 模型系列。简单说,它就是冲着“把活儿干完、而且干得更像专业人士”来的:做表格、做 PPT、写代码、看图、读超长文档、跑多步骤流程(甚至长时间运行的智能体任务),都更稳、更能交付。
核心结论
- 更适合“交付型工作”:在覆盖 44 个职业的 GDPval 评测里,GPT‑5.2 Thinking 的表现直接把行业基准拉高了。
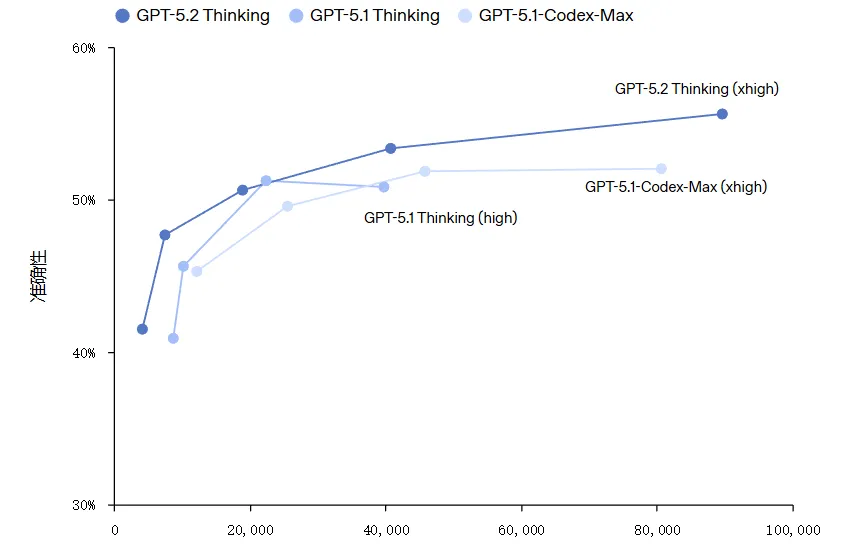
- 写代码更能打:SWE-bench Pro(公开版)做到 55.6%,SWE-bench Verified 做到 80.0%。
- 胡说更少:在去标识化的 ChatGPT 查询里,“至少包含一个错误的回复”的比例下降(6.2% vs 8.8%)。
- 长文档更不怕:在 OpenAI MRCRv2 等长上下文评测里表现领先,最高覆盖到 256k token 的输入区间评估。
- 更会用工具跑流程:Tau2-bench Telecom 做到 98.7%,多轮、多步骤任务更不容易中途掉链子。
关键基准对比(节选)
| 指标 | GPT‑5.2 Thinking | GPT‑5.1 Thinking |
|---|---|---|
| GDPval(胜出或持平)知识型工作任务 | 70.9% | 38.8%(GPT‑5) |
| SWE-Bench Pro(公开版)软件工程 | 55.6% | 50.8% |
| SWE-bench Verified 软件工程 | 80.0% | 76.3% |
| GPQA Diamond(无工具)科学问题 | 92.4% | 88.1% |
| CharXiv 推理(使用 Python)科学图表类问题 | 88.7% | 80.3% |
| HMMT(2025 年 2 月)数学竞赛 | 99.4% | 96.3% |
| FrontierMath(Tier 1–3)高等数学 | 40.3% | 31.0% |
| ARC-AGI-1(Verified)抽象推理 | 86.2% | 72.8% |
| ARC-AGI-2(Verified)抽象推理 | 52.9% | 17.6% |
面向“经济价值”的任务:GDPval
GDPval 这个测试很“接地气”:不是让模型做题,而是让它产出真实工作成果(比如销售演示文稿、会计表格、排班表、制造业图表、短视频脚本等),覆盖 9 个高 GDP 贡献行业的 44 种职业。
结果也很直观:在 GDPval 的知识型任务里,GPT‑5.2 Thinking 有 70.9% 的对比项目能“赢过或追平”顶尖行业专家。OpenAI 还给了一个很激进的估算:在有人类监督的情况下,它做这些任务的速度可能比专家快 11 倍以上,成本不到其 1%(速度与成本估算基于历史指标)。
编码:更可靠的工程交付
如果你更关心工程能力,那就看 SWE-bench。它会直接丢给模型一个真实代码仓库,让它自己改代码、出补丁来修 bug 或实现需求。
GPT‑5.2 Thinking 在 SWE-bench Pro(公开版)达到 55.6%,在 SWE-bench Verified 达到 80.0%。
放到日常开发里,可以理解成:它更有机会把一个需求从“看懂”做到“改完能跑”,而不是写一堆看起来像样但不能落地的代码。比如更擅长:
- 调试生产环境代码
- 实现功能需求
- 重构大型代码库
- 更少人工干预完成端到端修复交付
事实性:错误率下降
大家最在意的一点:别瞎编。OpenAI 说在一组来自 ChatGPT 的去标识化查询里,GPT‑5.2 Thinking 的错误率确实下来了。
- GPT‑5.2 Thinking:至少包含一个错误的回复 6.2%
- GPT‑5.1 Thinking:至少包含一个错误的回复 8.8%
当然,依然别把它当“真理机”,关键结论还是要复核。
长上下文:跨数十万 token 的整合能力
长文档这块,GPT‑5.2 Thinking 也主打一个“更能扛”。OpenAI MRCRv2 用来测模型能不能在超长文档里把分散的信息串起来,GPT‑5.2 Thinking 在这个评测里表现领先,并且在最长可达 256k token 的输入区间评估中更稳定。
如果你的任务更像“跑流程”(要多次调用工具、持续迭代),它还可以配合 Responses API 的 /compact 端点去扩展有效上下文窗口,支持更长时间的工作流。
视觉:图表与界面理解显著提升
视觉能力也有明显提升,尤其是“看图表”和“看界面截图”这类更贴近工作场景的任务。比如:
- CharXiv Reasoning(使用 Python):88.7%(相比 GPT‑5.1 Thinking 的 80.3%)
- ScreenSpot-Pro(使用 Python):86.3%(相比 64.2%)
工具调用:多轮任务更稳
τ2-bench 这种测试更像“真实客服/真实流程”:模型要跟模拟用户聊很多轮,同时还得自己用工具把事情办完。
- Tau2-bench Telecom:GPT‑5.2 Thinking 98.7%
- Tau2-bench Retail:GPT‑5.2 Thinking 82.0%
对你来说,意思就是:从多个系统拉数据、做分析、出最终结果,这条链路更不容易断。
可用性与定价(API)
API 中的模型命名方式:
- GPT‑5.2 Thinking:
gpt-5.2 - GPT‑5.2 Instant:
gpt-5.2-chat-latest - GPT‑5.2 Pro:
gpt-5.2-pro
价格(每百万 token):
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| gpt-5.2 / gpt-5.2-chat-latest | $1.75 | $0.175 | $14 |
| gpt-5.2-pro | $21 | - | $168 |
总结
总体来看,GPT‑5.2 这次升级的重点很明确:更适合做“长流程、要交付、要结果”的事。长上下文更稳、工具调用更顺、看图看界面更准、写代码也更能落地。如果你平时用 AI 的核心诉求就是省时间、少返工、能交付,那这波更新值得关注。
更多文章