GLM-Image:首个开源工业级自回归图像生成模型
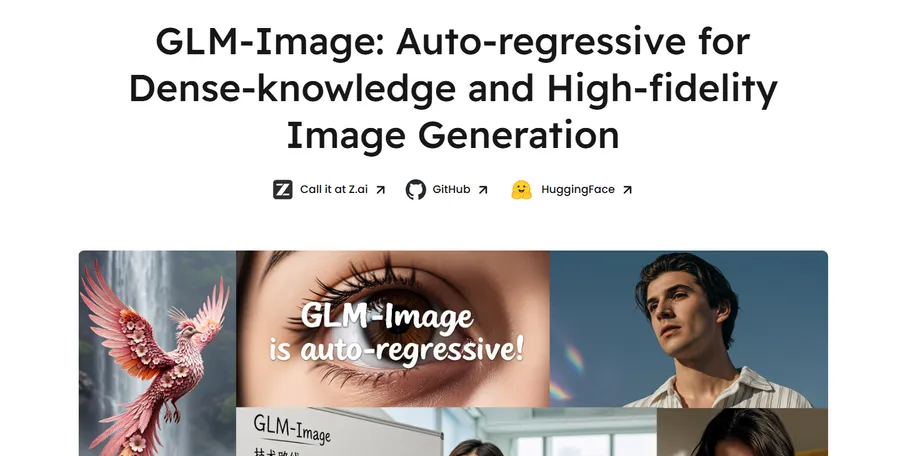
GLM-Image 是首个开源的工业级离散自回归图像生成模型,采用混合架构结合自回归模块与扩散解码器,在文本渲染和知识密集型生成场景中表现出色。本文介绍其技术特点与快速使用方法。
本文发布于 247 天前,内容可能已过时,请注意甄别。
1. 🚀 GLM-Image 来了
智谱 AI 最近发布了一个挺有意思的模型 —— GLM-Image,这是首个开源的工业级离散自回归图像生成模型。说白了,它就是用来生成图片的,但跟其他模型不太一样的是,它特别擅长处理那些需要精确文字渲染的场景,比如海报、PPT、科普插图这类东西。
有什么特别的?
- 混合架构:结合了 90 亿参数的自回归模块(基于 GLM-4-9B)和 70 亿参数的扩散解码器
- 文字渲染很强:在 CVTG-2K 和 LongText-Bench 测试中拿了开源模型第一,尤其是中文文字的准确率达到了 97.88%
- 知识密集型生成:特别适合那些需要准确表达复杂信息的场景,不只是好看,还得”说得清楚”
- 功能丰富:不仅能文字生图,还支持图像编辑、风格迁移等
官方资源:
- 🤗 Hugging Face:zai-org/GLM-Image
- 📦 ModelScope:ZhipuAI/GLM-Image
- 📖 技术博客:GLM-Image Technical Blog
2. 技术架构:为什么这么设计?
2.1 混合架构的思路
传统的扩散模型虽然生成的图片质量不错,但在理解复杂指令、准确渲染文字这些方面还是有点力不从心。GLM-Image 的团队想了个办法:把任务拆成两部分。
- 自回归生成器(9B 参数):基于 GLM-4-9B,负责”理解”你想要什么,生成包含语义信息的 token
- 扩散解码器(7B 参数):采用 CogView4 的架构,负责把这些 token “画”成高质量的图片
这就像是先有个人理解你的需求画个草图,然后再有个画师把草图细化成精美的作品。这种分工让模型既能准确理解复杂的指令,又能生成高质量的细节。
2.2 几个关键技术点
Semantic-VQ Token:选对”语言”很重要
GLM-Image 用的是 semantic-VQ 来做视觉 token 化。简单说,就是把图片转换成模型能理解的”语言”。相比传统的 VQVAE,这种方式训练损失更低(约 3 vs 7),语义相关性更强,更适合自回归建模。
渐进式生成:先布局后细化
在生成高分辨率图片时,GLM-Image 会先生成一个低分辨率的版本(约 256 个 token),确定整体布局,然后再生成高分辨率的细节(1024-4096 个 token)。这样做的好处是布局更可控,不容易”跑偏”。
Glyph-byT5:专治”提笔忘字”
为了让模型能准确渲染文字(尤其是中文),GLM-Image 引入了一个轻量级的 Glyph-byT5 模型,专门做字符级编码。这就是为什么它在文字渲染上表现这么好的原因。
解耦强化学习:各司其职
在后训练阶段,GLM-Image 用 GRPO 算法分别优化两个模块:
- 自回归模块关注语义准确性、美学评分
- 扩散解码器关注细节质量、文字精度
这种”分工明确”的训练方式让每个模块都能发挥最大作用。
3. 快速上手
3.1 环境准备
首先需要安装最新版本的 transformers 和 diffusers,因为 GLM-Image 用到了一些新特性:
       pip install git+https://github.com/huggingface/transformers.git
pip install git+https://github.com/huggingface/diffusers.git硬件要求:Python 3.8+、CUDA 11.8+、至少 24GB GPU 显存(如果显存不够,可以试试降低分辨率)
3.2 生成第一张图片
代码很简单,加载模型然后调用就行:
       import torch
from diffusers.pipelines.glm_image import GlmImagePipeline

# 加载模型
pipe = GlmImagePipeline.from_pretrained(
    "zai-org/GLM-Image",
    torch_dtype=torch.bfloat16,
    device_map="cuda"
)

# 生成图像
prompt = "一只可爱的熊猫在竹林中吃竹子,水墨画风格"
image = pipe(
    prompt=prompt,
    height=32 * 32,  # 1024px,必须是 32 的倍数
    width=32 * 32,
    num_inference_steps=50,  # 步数越多质量越好,但也越慢
    guidance_scale=1.5,      # 控制生成图像与提示词的匹配度
    generator=torch.Generator(device="cuda").manual_seed(42),
).images[0]

image.save("output.png")
3.3 图像编辑
GLM-Image 还支持基于参考图像的编辑,比如换个背景什么的:
       from PIL import Image

# 加载你想编辑的图片
reference_image = Image.open("input.jpg").convert("RGB")

# 告诉模型你想怎么改
edited_image = pipe(
    prompt="将雪地森林的背景替换为地铁站",
    image=[reference_image],  # 可以传多张图片
    height=33 * 32,
    width=32 * 32,
    num_inference_steps=50,
    guidance_scale=1.5,
).images[0]

edited_image.save("edited.png")几个小提示:
height和width必须是 32 的倍数,这是模型架构决定的num_inference_steps推荐 50 步,质量和速度的平衡点guidance_scale推荐 1.5,太高可能会过拟合
4. 性能到底怎么样?
4.1 文字渲染:这是强项
GLM-Image 最亮眼的地方就是文字渲染能力,在多个基准测试中都拿了开源模型第一:
CVTG-2K 测试(复杂视觉文本生成):
- 平均单词准确率:0.9116(开源第一)
- NED 得分:0.9557(开源第一)
具体到多区域文本生成,表现也很稳:
- 2 个区域:91.03%
- 3 个区域:92.09%
- 4 个区域:91.69%
- 5 个区域:89.75%
对比一下,FLUX.1 的平均准确率只有 49.65%,SD3.5 Large 是 65.48%,差距还是挺明显的。
LongText-Bench 测试(长文本渲染):
- 英文:0.9524(开源第一)
- 中文:0.9788(开源第一)
中文文字渲染达到 97.88% 的准确率,这个数字还是很惊人的。测试覆盖了招牌、海报、PPT、对话框等 8 种常见场景。
4.2 通用图像生成:也不差
虽然 GLM-Image 主打文字渲染,但在通用图像生成上也没掉链子:
OneIG-Bench:
- 英文:0.528(对齐度 0.805、文本理解 0.969)
- 中文:0.511(对齐度 0.738、文本理解 0.976)
DPG-Bench:
- 整体:84.78
- 全局理解:87.74
- 实体识别:90.25
- 关系推理:92.15
TIFF-Bench:
- 短文本:81.01
- 长文本:81.02
总的来说,在通用图像生成质量上能跟主流的潜在扩散模型打个平手,但在文字渲染和知识密集型场景中就明显领先了。
5. 总结一下
GLM-Image 是个挺有意思的尝试,它不只是想生成好看的图片,更想让 AI 能”说清楚”复杂的信息。通过自回归 + 扩散的混合架构,它在文字渲染这块做到了开源模型的天花板,中文文字准确率达到 97.88%,这对于需要制作海报、PPT、科普插图的场景来说还是很实用的。
几个亮点:
- 架构设计很巧妙,把”理解”和”绘画”分开处理
- 文字渲染能力确实强,尤其是中文
- 完全开源(MIT 许可证),可以商用
- 不只能生图,还能编辑、风格迁移
从技术角度看,GLM-Image 代表了一个新方向:从”纯视觉生成”到”认知生成”。未来的图像生成模型可能不只是画得好看,还得”懂”你想表达什么,能准确地把复杂信息视觉化。这对教育、商业、科普等领域来说,想象空间还是挺大的。
如果你正好有文字渲染的需求,或者想做些知识密集型的图像生成,不妨试试 GLM-Image。
相关资源:
更多文章