
AI Tools 5 min read
【重磅发布】Fun-ASR-Nano 技术指南:端到端实时语音识别大模型
FunAudioLLM 于 2025-12-15 发布 Fun-ASR-Nano-2512:端到端语音识别大模型,支持 31 种语言、7 大方言、低延迟实时转写。本文介绍安装、推理与 VAD 结合实战。
本文发布于 277 天前,内容可能已过时,请注意甄别。
1. 🚀 重磅发布:Fun-ASR-Nano-2512
2025年12月15日,FunAudioLLM 团队正式推出了 Fun-ASR-Nano-2512。这是一款经过千万小时级真实语音数据训练的端到端语音识别(ASR)大模型,专为高精度、低延迟场景设计。
核心亮点
- 极致性能:支持低延迟实时转写,具备强大的上下文理解能力。
- 全能覆盖:
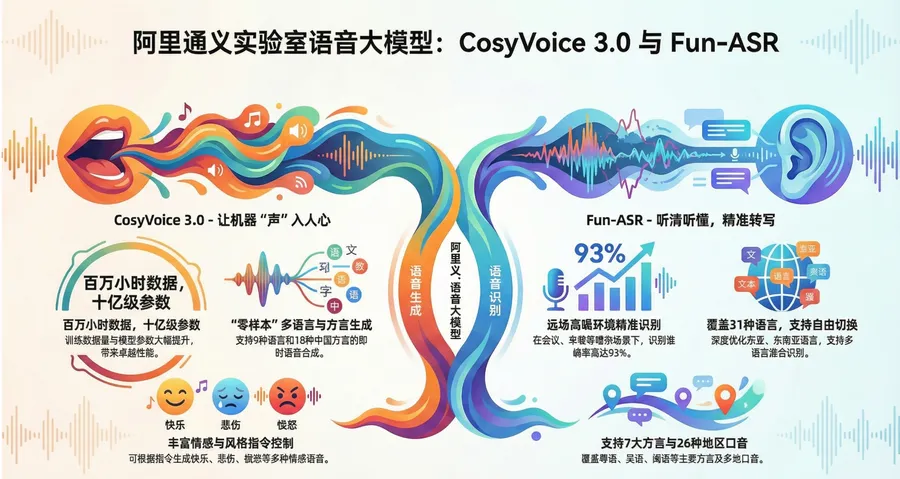
- 31 种语言:重点优化东亚、东南亚语言,支持中英日韩等混合识别。
- 7 大方言:吴语、粤语、闽南语、客家话、赣语、湘语、晋语。
- 26 种口音:覆盖河南、陕西、四川、重庆、云贵广等 20+ 地区口音。
- 抗噪能力:针对远场、高噪环境(会议室、车载、工业现场)深度优化,识别率高达 93%。
- 音乐歌词识别:即使在背景音乐干扰下,也能准确识别歌词内容。
官方资源直达:
- 📦 模型下载 (ModelScope):Fun-ASR-Nano-2512
- 📦 代码仓库:GitHub - FunAudioLLM/Fun-ASR
- 🎮 在线体验:ModelScope 创空间
2. 环境安装
Fun-ASR 的部署非常简洁,建议使用 Python 3.8+ 环境。
       # 1. 克隆代码或直接安装依赖
pip install -r requirements.txt

# 或者手动安装核心库 (FunASR)
pip install funasr modelscope注意:
- 推荐使用 GPU 进行推理,请确保安装了与 CUDA 版本匹配的
torch。 - Windows 用户建议使用 Conda 环境管理依赖。
3. 快速上手:AutoModel 推理
官方推荐使用 AutoModel 接口,它会自动处理模型下载与加载,代码最简。
3.1 基础识别示例
       from funasr import AutoModel

def main():
    # 指定 ModelScope 模型 ID,自动下载
    model_dir = "FunAudioLLM/Fun-ASR-Nano-2512"

    # 初始化模型
    # trust_remote_code=True 是必须的,因为 Nano 模型包含自定义代码
    model = AutoModel(
        model=model_dir,
        trust_remote_code=True,
        remote_code="./model.py",  # 加载模型自定义实现
        device="cuda:0",           # 使用 GPU,CPU 可改为 "cpu"
    )

    # 推理音频
    wav_path = f"{model.model_path}/example/zh.mp3"
    res = model.generate(input=[wav_path], cache={}, batch_size=1)

    print("识别结果:", res[0]["text"])

if __name__ == "__main__":
    main()
3.2 进阶:结合 VAD (语音活动检测)
对于长音频,建议结合 VAD 模型进行切分,以提高识别准确率和稳定性。Fun-ASR 无缝集成了 fsmn-vad。
           # 初始化带 VAD 的模型
    model = AutoModel(
        model=model_dir,
        trust_remote_code=True,
        vad_model="fsmn-vad",
        vad_kwargs={"max_single_segment_time": 30000}, # 最大单段时长 30s
        remote_code="./model.py",
        device="cuda:0",
    )

    res = model.generate(input=[wav_path], cache={}, batch_size=1)
    print("VAD + ASR 结果:", res[0]["text"])
4. 直连推理模式 (Direct Inference)
如果你需要更底层的控制,或者希望绕过 AutoModel 的封装,可以直接调用 FunASRNano 类。
       from model import FunASRNano

def main():
    model_dir = "FunAudioLLM/Fun-ASR-Nano-2512"
    # 加载模型
    m, kwargs = FunASRNano.from_pretrained(model=model_dir, device="cuda:0")
    m.eval()

    # 推理
    wav_path = f"{kwargs['model_path']}/example/zh.mp3"
    res = m.inference(data_in=[wav_path], **kwargs)

    # 结果提取方式略有不同
    print("直连推理结果:", res[0][0]["text"])

if __name__ == "__main__":
    main()
5. 常见参数说明
| 参数 | 说明 |
|---|---|
model_dir | 模型名称(ModelScope ID)或本地路径 |
trust_remote_code | 必须设为 True 以加载 Nano 模型的自定义架构 |
remote_code | 指定模型实现代码位置,通常为 ./model.py |
device | cuda:0 (GPU) 或 cpu |
vad_model | 推荐使用 fsmn-vad 进行长音频切分 |
batch_size | 批处理大小,根据显存调整,默认为 1 |
6. 总结
Fun-ASR-Nano-2512 的发布填补了高性能、多语种、抗噪 ASR 模型的空白。结合 CosyVoice 3.0,FunAudioLLM 家族现在提供了一套完整的“听(ASR)”与“说(TTS)”解决方案,非常适合构建全双工语音助手、数字人交互等应用。
更多文章
ZCode 说只是做索引,可它翻开的不止当前代码

OpenClaw 2.0 发布:Agent 终于能把没做完的事接着做

“牛来”揭面:智谱 GLM-5.3-Flash 匿名期跑出 44 万亿 Token
GLM-5.3 发布:基座没换,智谱把后训练推到数十倍任务环境

DeepSeek Harness 开源:把 Agent 的整套运行底座拆开了

FFmpeg 9.0 “Lei” 发布:这个版本号,纪念一位中国音视频开发者

DeepSeek-V4-Flash 正式上线:性能超过 GLM,逼近 Opus 4.8,价格更狠

GPT-5.6 Luna 直接降价 80%:百万 Token 输出只要 1.2 美元

Kimi K3 真开源了:2.8T 模型如何只激活 104B 参数?
相关文章
暂无相关文章