
DeepSeek OCR App:开源自部署的 React+FastAPI 文字识别应用 | 四种模式+Docker部署+完整教程
DeepSeek OCR App 开源文字识别应用详解:React+FastAPI 全栈开发,支持文本识别、图像描述、内容查找、自定义提示四大模式。提供 Docker 一键部署、GPU 加速、拖拽上传、可视化标注等功能。完整源码教程,适合个人使用和企业部署。
本文发布于 322 天前,内容可能已过时,请注意甄别。
DeepSeek OCR App 是什么?
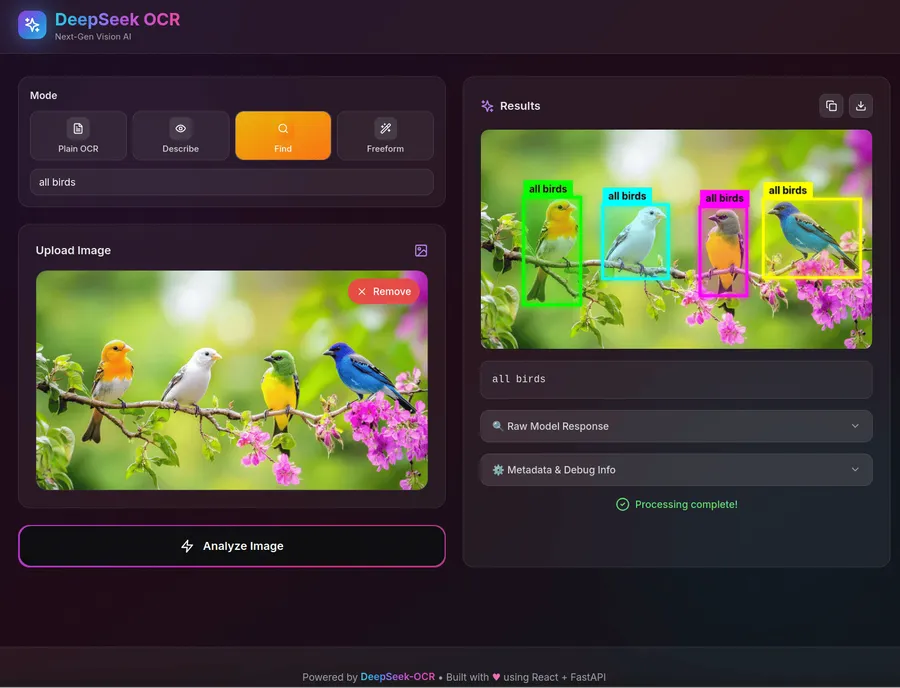
简单来说,DeepSeek OCR App 就是一个很实用的文字识别网页应用。它用 React 做前端界面,FastAPI 做后端服务,整个架构还挺现代化的。最关键的是集成了 DeepSeek-OCR 这个识别模型,不管是界面还是处理速度都做得不错。
除了基本的文字识别,这个应用还能描述图片内容、找特定的文字,甚至可以自定义一些处理需求。总的来说,算是个比较全面的文档处理工具了。
💡 如果你正好需要一个 OCR 应用,这个项目基本上开箱即用,前后端都给你准备好了。
核心特性与功能
🎯 四种 OCR 模式
这个应用给你准备了四种不同的识别方式:
- Plain OCR(纯文本识别):就是最基础的文字提取,把图片里的字都扒出来
- Describe(智能描述):让 AI 看图说话,告诉你这张图片是什么内容
- Find(内容查找):找特定的文字,还会用框框标出来在哪里
- Freeform(自由模式):你可以自己写提示词,让它按你的要求处理
🎨 界面做得还不错
前端的设计挺用心的:
- 玻璃质感设计:看起来比较现代,有那种半透明的效果
- 拖拽上传:直接把文件拖进去就行,最大支持 100MB
- 文件管理:不满意可以一键删除重新上传
- 框框标注:找到的文字会用框标出来,坐标还挺准的
- 动画效果:用了 Framer Motion,交互起来比较顺滑
- 结果处理:识别完了可以直接复制或者下载
- 设置面板:有个折叠的高级选项,需要的时候展开
- 多种格式:结果可以显示成 HTML 或者 Markdown 格式
⚡ 后端性能还行
- 模型推理:用的是 PyTorch + Transformers 4.46 这套组合
- GPU 加速:支持 NVIDIA 显卡,RTX 3090 和 5090 都测试过没问题
- 多框处理:可以同时标注多个区域,格式是
[[x1,y1,x2,y2], [x1,y1,x2,y2]] - 坐标转换:会把标准化坐标(0-999)转换成实际像素位置
- 配置管理:用 python-decouple 管理环境变量,比较灵活
技术架构详解
🛠️ 技术栈组成
前端技术栈
- React 18:最新版本的 React 框架
- Vite 5:现代化的构建工具,提供快速开发体验
- TailwindCSS 3:实用优先的 CSS 框架
- Framer Motion 11:强大的动画和交互库
后端技术栈
- FastAPI:高性能的 Python Web 框架
- PyTorch:深度学习推理引擎
- Transformers 4.46:Hugging Face 模型库
- DeepSeek-OCR:核心 OCR 识别模型
部署与运维
- Docker + Docker Compose:容器化部署方案
- Nginx:反向代理服务器
- 多阶段构建:优化的 Docker 镜像构建流程
📁 项目结构
       deepseek-ocr/
├── backend/              # FastAPI 后端服务
│   ├── main.py          # 主应用入口
│   ├── requirements.txt # Python 依赖
│   └── Dockerfile       # 后端容器配置
├── frontend/            # React 前端应用
│   ├── src/
│   │   ├── components/  # React 组件
│   │   ├── App.jsx     # 主应用组件
│   │   └── main.jsx    # 应用入口
│   ├── package.json    # Node.js 依赖
│   ├── nginx.conf      # Nginx 配置
│   └── Dockerfile      # 前端容器配置
├── models/             # 模型缓存目录
└── docker-compose.yml  # 容器编排配置
怎么快速上手?
🐳 用 Docker 最省事
如果你不想折腾环境,直接用 Docker Compose 是最简单的:
       # 克隆项目仓库
git clone https://github.com/rdumasia303/deepseek_ocr_app.git
cd deepseek_ocr_app

# 一键启动服务
docker compose up --build
⚙️ 环境配置
硬件要求
跑这个应用对电脑还是有点要求的:
- 显卡:最好有个 8-12GB 显存的 NVIDIA 卡(推荐 RTX 3090、RTX 4090、RTX 5090)
- 内存:16GB 内存比较保险
- 硬盘:至少留 20GB 空间给模型文件和 Docker 镜像
- 网络:第一次启动要下载模型(约5-10GB),网络要稳定点
⚠️ RTX 5090 Ubuntu 用户特别注意:
如果你用的是 RTX 5090 显卡在 Ubuntu 24.04 上,驱动安装比较麻烦,需要特别注意:
关键要求:
- 必须使用开源驱动(nvidia-driver-580-open 或更新版本)
- 升级内核到 6.11+(推荐 6.14+ 更稳定)
- 必须在 BIOS/UEFI 中启用 Resize Bar(这个很关键!)
快速安装步骤:
       # 1. 安装开源驱动
sudo add-apt-repository ppa:graphics-drivers/ppa
sudo apt update
sudo apt remove --purge nvidia*
sudo apt install nvidia-driver-580-open

# 2. 升级内核
sudo apt install --install-recommends linux-generic-hwe-24.04
sudo update-initramfs -u

# 3. 重启后进入 BIOS 启用 Resize Bar
# 4. 验证安装
nvidia-smi
不启用 Resize Bar 的话可能会黑屏,这是 Blackwell GPU 的特殊要求。
软件要求
- Docker:20.10+ 版本
- Docker Compose:2.0+ 版本
- NVIDIA Docker:支持 GPU 容器运行时(可选)
🔧 环境变量配置
创建 .env 文件进行自定义配置:
       # 服务端口配置
BACKEND_PORT=8000
FRONTEND_PORT=3000

# 文件上传限制
MAX_UPLOAD_SIZE=100MB

# GPU 设备配置
CUDA_VISIBLE_DEVICES=0

# 模型配置
MODEL_CACHE_DIR=./models
使用教程
📤 怎么上传文件
- 拖拽上传:最简单,直接把图片拖到上传区域就行
- 点击上传:不习惯拖拽的话,点按钮选文件也可以
- 支持格式:JPG、PNG、BMP、GIF 这些常见格式都支持
- 文件大小:默认最大 100MB,一般的图片都够用了
🎛️ OCR 模式选择
Plain OCR 模式
       用途:提取图像中的所有文本内容
适用场景:文档数字化、文本录入、内容提取
输出格式:纯文本字符串
Describe 模式
       用途:生成图像的智能描述
适用场景:图像标注、内容分析、辅助功能
输出格式:自然语言描述
Find 模式
       用途:查找特定内容并标注位置
适用场景:关键信息定位、内容检索、质量检查
输出格式:文本 + 边界框坐标
Freeform 模式
       用途:自定义提示词处理
适用场景:专业化任务、特殊需求、灵活处理
输出格式:根据提示词定制
📊 结果处理
处理完成后,应用提供多种结果管理功能:
- 文本复制:一键复制识别结果到剪贴板
- 文件下载:将结果保存为文本文件
- 边界框可视化:在原图上显示识别区域
- 格式化显示:支持 HTML 和 Markdown 渲染
API 使用指南
🔌 REST API 接口
DeepSeek OCR App 提供了标准的 REST API 接口:
POST /api/ocr
请求格式:
       curl -X POST "http://localhost:8000/api/ocr" \
  -F "file=@your_image.jpg" \
  -F "mode=plain" \
  -F "custom_prompt=your_custom_prompt"
参数说明:
file:图像文件(必需)mode:OCR 模式(plain/describe/find/freeform)custom_prompt:自定义提示词(freeform 模式使用)find_text:查找的目标文本(find 模式使用)
响应格式:
       {
  "success": true,
  "result": {
    "text": "识别的文本内容",
    "bounding_boxes": [[x1, y1, x2, y2]],
    "confidence": 0.95,
    "processing_time": 1.23
  }
}
🐍 Python SDK 集成
       import requests

def ocr_request(image_path, mode="plain", custom_prompt=None):
    """
    调用 DeepSeek OCR API

    Args:
        image_path: 图像文件路径
        mode: OCR 模式
        custom_prompt: 自定义提示词

    Returns:
        dict: API 响应结果
    """
    url = "http://localhost:8000/api/ocr"

    files = {"file": open(image_path, "rb")}
    data = {"mode": mode}

    if custom_prompt:
        data["custom_prompt"] = custom_prompt

    response = requests.post(url, files=files, data=data)
    return response.json()

# 使用示例
result = ocr_request("document.jpg", mode="describe")
print(result["result"]["text"])
开发与定制
🔨 想自己改代码?
如果你想在这个基础上改点东西:
后端开发
       # 进入后端目录
cd backend

# 创建虚拟环境
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# 安装依赖
pip install -r requirements.txt

# 启动开发服务器
uvicorn main:app --reload --host 0.0.0.0 --port 8000
前端开发
       # 进入前端目录
cd frontend

# 安装依赖(推荐使用 yarn 或 pnpm)
yarn install
# 或者 pnpm install

# 启动开发服务器
yarn dev
# 或者 pnpm dev
🎨 界面定制
前端使用 TailwindCSS,可以轻松定制样式:
       // 修改主题色彩
const customTheme = {
  primary: '#your-color',
  secondary: '#your-secondary-color',
  background: 'your-background'
}

// 自定义组件样式
<div className="bg-gradient-to-r from-blue-500 to-purple-600">
  {/* 你的内容 */}
</div>
🔧 功能扩展
可以通过以下方式扩展功能:
- 添加新的 OCR 模式:在后端
main.py中添加新的处理逻辑 - 集成其他模型:替换或添加不同的 OCR 模型
- 增强 UI 组件:在前端添加新的交互功能
- API 功能扩展:添加批量处理、异步任务等功能
故障排除
⚠️ 遇到问题怎么办
GPU 检测问题
       # 检查 NVIDIA 驱动
nvidia-smi

# 检查 Docker GPU 支持
docker run --rm --gpus all nvidia/cuda:11.0-base nvidia-smi
端口冲突
       # 检查端口占用
netstat -tulpn | grep :8000

# 修改端口配置
# 在 docker-compose.yml 中修改端口映射
前端构建问题
       # 清理缓存
yarn cache clean
# 或 pnpm store prune

# 重新安装依赖
rm -rf node_modules package-lock.json
yarn install
模型下载问题
       # 手动下载模型到 models 目录
# 或配置代理环境变量
export HTTP_PROXY=http://your-proxy:port
export HTTPS_PROXY=http://your-proxy:port
性能优化建议
🚀 部署优化
-
GPU 内存管理
- 合理设置批处理大小
- 使用模型量化减少显存占用
- 配置内存清理策略
-
网络优化
- 启用 gzip 压缩
- 配置 CDN 加速
- 优化图像上传大小
-
缓存策略
- 启用模型缓存
- 配置结果缓存
- 使用 Redis 缓存频繁请求
📈 监控与日志
       # docker-compose.yml 中添加监控
services:
  app:
    logging:
      driver: "json-file"
      options:
        max-size: "10m"
        max-file: "3"
写在最后
总的来说,DeepSeek OCR App 算是个比较实用的 OCR 工具。技术栈用的是 React + FastAPI,界面做得不错,功能也够用,部署起来也不算太麻烦。
主要优点:
- 🎯 功能够用:四种模式基本覆盖了常见需求
- 🎨 界面不错:玻璃质感设计,看起来比较现代
- ⚡ 性能还行:有 GPU 加速,速度可以接受
- 🐳 部署简单:Docker 一键启动,省事
- 🔧 好改代码:项目结构清晰,想改东西不难
不管你是自己用用,还是公司要部署,或者想在这基础上改点什么,这个项目都算是个不错的起点。而且作者还在持续更新,应该会越来越好用。
参考资源
更多文章







相关文章
暂无相关文章